Il nuovo comando “Disallow AI Training” consente ai siti di conservare la visibilità nei motori di ricerca e pubblicare una preferenza contraria all’uso dei contenuti per l’addestramento.
Cloudflare ha introdotto un controllo pensato per i siti che vogliono restare visibili nei risultati di ricerca e, nello stesso tempo, escludere i propri contenuti dall’addestramento dei modelli di intelligenza artificiale. L’impostazione si chiama “Disallow AI Training” e interviene soprattutto sui crawler misti, cioè programmi automatizzati utilizzati dallo stesso operatore per più finalità.
La novità affronta un’esigenza concreta per editori, autori, aziende e gestori di contenuti. La presenza nei motori di ricerca continua a essere una fonte rilevante di traffico e scoperta. L’accesso destinato all’addestramento dei modelli risponde invece a una finalità differente, che molti siti desiderano amministrare attraverso una scelta separata.
Perché i crawler misti complicano la gestione dei contenuti
Un crawler dedicato esclusivamente alla ricerca può essere autorizzato senza coinvolgere altri utilizzi. Un crawler riservato all’addestramento può essere bloccato con una regola specifica. La situazione diventa meno lineare quando un singolo bot raccoglie pagine sia per alimentare un indice di ricerca sia per attività legate ai modelli AI.
In questo scenario, il blocco completo rischia di ridurre la presenza del sito nella ricerca. L’autorizzazione generale lascia invece aperto un accesso più ampio di quello desiderato. “Disallow AI Training” introduce una terza possibilità: il crawler può continuare a svolgere la funzione di ricerca, mentre il sito pubblica una preferenza contraria all’impiego dei contenuti per l’addestramento.
Cloudflare applica questa preferenza attraverso Bot Preference Sync, che inserisce nel file robots.txt l’indicazione relativa al training. Il controllo riguarda quindi la categoria Training. Le decisioni riferite a Search e Agent restano separate, permettendo al gestore del dominio di definire una politica più articolata.
Search, Training e Agent diventano scelte distinte
La suddivisione proposta da Cloudflare organizza l’attività automatizzata in tre aree. Search comprende la scansione finalizzata alla scoperta e all’indicizzazione delle pagine. Training riguarda la raccolta di materiali destinati all’addestramento AI. Agent identifica gli accessi effettuati da sistemi automatizzati che consultano un sito durante l’esecuzione di un compito.
Queste categorie aiutano a evitare una regola unica per usi molto diversi. Un editore può voler favorire la ricerca, dichiarare il divieto di addestramento e limitare l’azione degli agenti su determinate pagine. Una piccola impresa può scegliere una configurazione diversa in base al ruolo che il traffico organico, i contenuti proprietari e la pubblicità hanno nel proprio modello operativo.
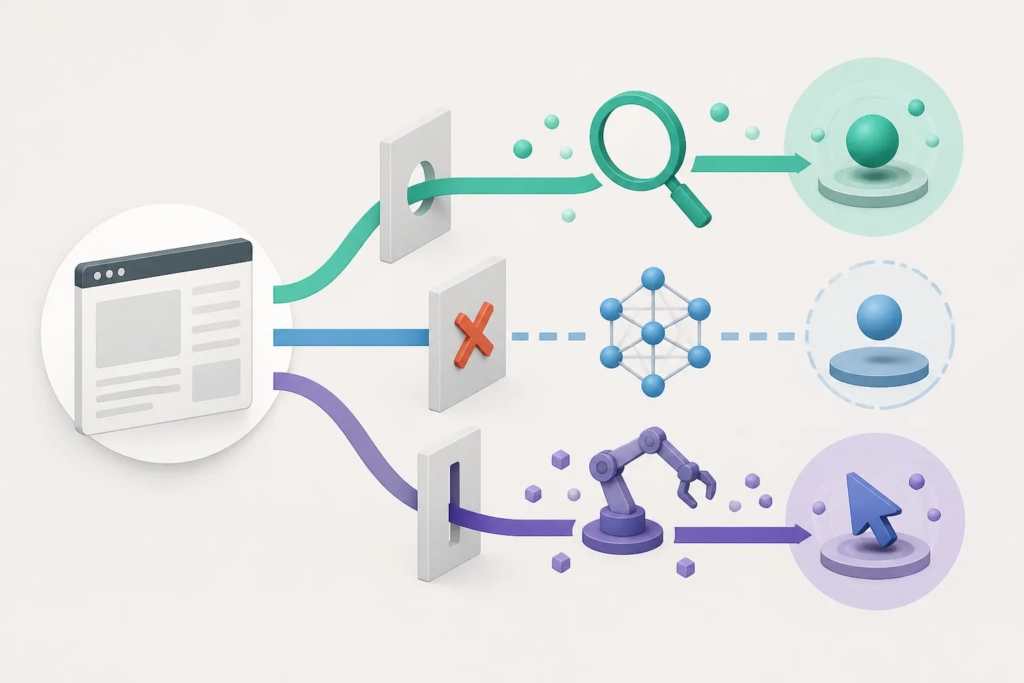
Nel sistema di Cloudflare, Applebot, Bingbot e Googlebot rientrano tra i crawler misti classificati come “Accountable”. Con “Disallow AI Training” questi bot possono continuare a effettuare la scansione per la ricerca. L’opzione “Block” mantiene una funzione differente e interrompe completamente il loro accesso.
La definizione “Accountable” appartiene allo schema adottato da Cloudflare e descrive gli operatori dai quali il servizio si attende un trattamento coerente con le preferenze pubblicate. L’efficacia pratica di un’indicazione nel robots.txt dipende dal suo recepimento da parte del crawler. Al momento dell’annuncio, il supporto automatico di Bing alla preferenza di no-training risultava ancora in fase di adozione. Conviene quindi leggere il nuovo comando come un controllo più preciso, il cui risultato può variare in base all’operatore coinvolto.
Il caso dei crawler già separati
Per alcuni fornitori la distinzione tecnica esiste già a livello di bot. Cloudflare indica che Amazon, Anthropic, Meta e OpenAI utilizzano crawler separati per Search e Training. In questi casi, il blocco del crawler dedicato all’addestramento non incide sulla scansione destinata alla ricerca.
La nuova impostazione acquista particolare rilievo proprio dove questa separazione non è presente. Consente di esprimere finalità diverse senza rinunciare in via preventiva alla reperibilità dei contenuti. Per i publisher, la differenza è significativa: l’indicizzazione sostiene la distribuzione degli articoli, mentre l’addestramento coinvolge decisioni editoriali e commerciali autonome.
I preset per i nuovi domini
Dal 15 settembre 2026 Cloudflare propone ai nuovi domini configurazioni iniziali differenziate anche in base alla presenza di pubblicità. Per i siti che monetizzano attraverso annunci, il preset mantiene Search su “Allow”, imposta Training su “Disallow AI Training” e applica agli agenti il blocco nelle pagine che contengono inserzioni.
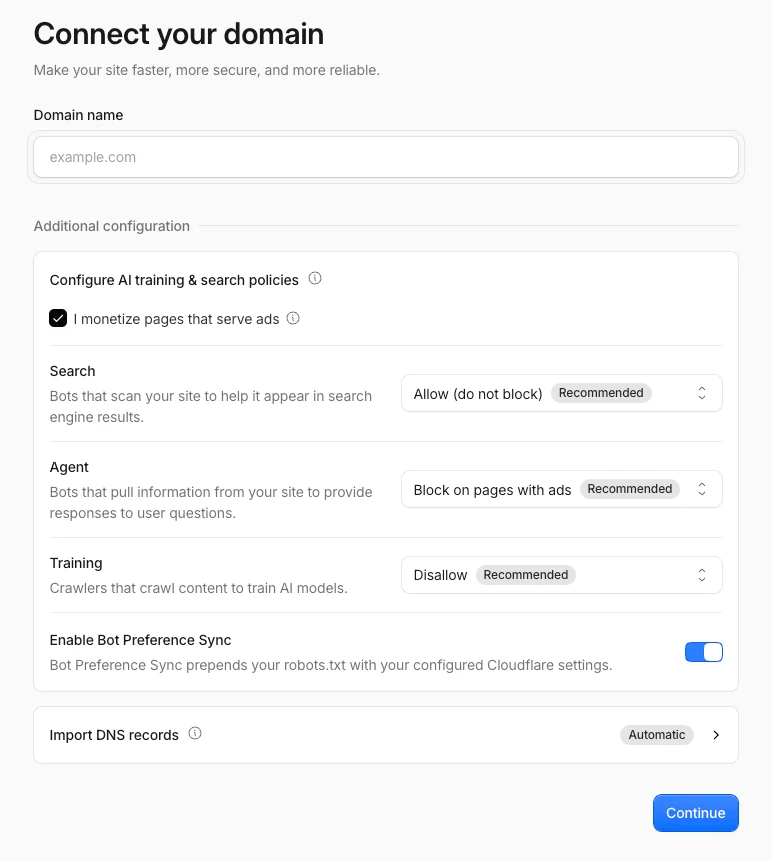
La configurazione mostra come i controlli sui bot stiano diventando parte della gestione ordinaria di un sito. Ricerca, riutilizzo dei contenuti e accesso automatizzato possono avere effetti distinti sulla distribuzione e sulla monetizzazione. Trattarli separatamente rende le impostazioni più comprensibili anche per chi non dispone di un’infrastruttura tecnica complessa.
Cloudflare sta inoltre superando i precedenti controlli “Block AI Bots” e “Managed Robots.txt” in favore del nuovo modello granulare. Chi utilizza le vecchie opzioni dovrà quindi verificare la configurazione risultante dalla migrazione e controllare che le preferenze corrispondano alle proprie esigenze editoriali.
Che cosa cambia per editori e gestori di siti
La prima conseguenza pratica riguarda la possibilità di formulare una politica esplicita per ciascun tipo di utilizzo. Prima di applicare una configurazione, è utile definire il ruolo della ricerca nella distribuzione dei contenuti, stabilire la preferenza relativa all’addestramento e valutare l’accesso degli agenti alle pagine monetizzate.
Dopo l’attivazione, il gestore può verificare il robots.txt prodotto da Bot Preference Sync e controllare che Search, Training e Agent abbiano valori coerenti. Questa revisione è particolarmente importante per i domini provenienti dai controlli in via di dismissione, poiché una regola eccessivamente ampia potrebbe limitare anche la scansione utile all’indicizzazione.
Il sistema non equivale a una garanzia universale contro ogni possibile uso dei contenuti. Pubblica una preferenza strutturata e la collega ai controlli disponibili sulla rete Cloudflare. Il comportamento effettivo resta legato all’adozione delle indicazioni da parte dei singoli operatori e potrà evolvere con gli aggiornamenti dei crawler.
Verso una gestione per finalità
L’evoluzione dei crawler rende sempre meno adeguata la distinzione generica tra bot consentiti e bot bloccati. Lo stesso contenuto può essere indicizzato, utilizzato per addestrare un modello oppure consultato da un agente durante un’attività. Ciascuna funzione genera conseguenze differenti per visibilità, controllo editoriale e sostenibilità economica.
Cloudflare prevede di estendere in futuro questo approccio anche alle sintesi generate dall’intelligenza artificiale, attraverso una gestione centralizzata. I dettagli operativi potranno cambiare, mentre la direzione appare già chiara: i siti avranno bisogno di strumenti capaci di esprimere preferenze legate allo scopo dell’accesso, anziché limitarsi all’identità dichiarata dal bot.
Per il settore editoriale, il nuovo controllo offre una soluzione intermedia utile. La scoperta attraverso la ricerca può continuare, l’esclusione dal training viene dichiarata in modo specifico e gli agenti ricevono regole autonome. La qualità del risultato dipenderà dall’adozione da parte degli operatori, dalla corretta configurazione del dominio e dall’aggiornamento periodico delle preferenze.
Fonti