Un preprint propone di riconoscere le risposte inaffidabili osservando come il contesto circola tra i token. Il metodo usa misure topologiche e richiede ancora verifiche indipendenti.
Le allucinazioni dei modelli linguistici vengono spesso individuate esaminando il testo generato, confrontandolo con fonti attendibili oppure chiedendo al modello di produrre più risposte. Un nuovo filone di ricerca prova a intervenire prima, cercando nell’elaborazione interna del modello i segnali associati a una risposta inaffidabile.
Il preprint “Detecting Hallucination in LLMs: Tracing the Topological Signatures of Impaired Context Sharing”, pubblicato su arXiv il 17 settembre 2026, propone di analizzare la struttura dei grafi di attenzione. L’ipotesi è che le allucinazioni lascino una traccia riconoscibile nel modo in cui il modello condivide e comprime le informazioni contestuali durante la generazione.
Per allucinazione si intende in questo caso una risposta formulata in modo plausibile che contiene informazioni inesatte o prive di un adeguato fondamento. La fluidità del linguaggio rende difficile riconoscere il problema dalla sola forma del testo. Un sistema diagnostico basato sui meccanismi interni potrebbe quindi aggiungere un livello di controllo utile nei processi in cui accuratezza e verificabilità hanno un peso rilevante.
Dalle mappe di attenzione a un grafo
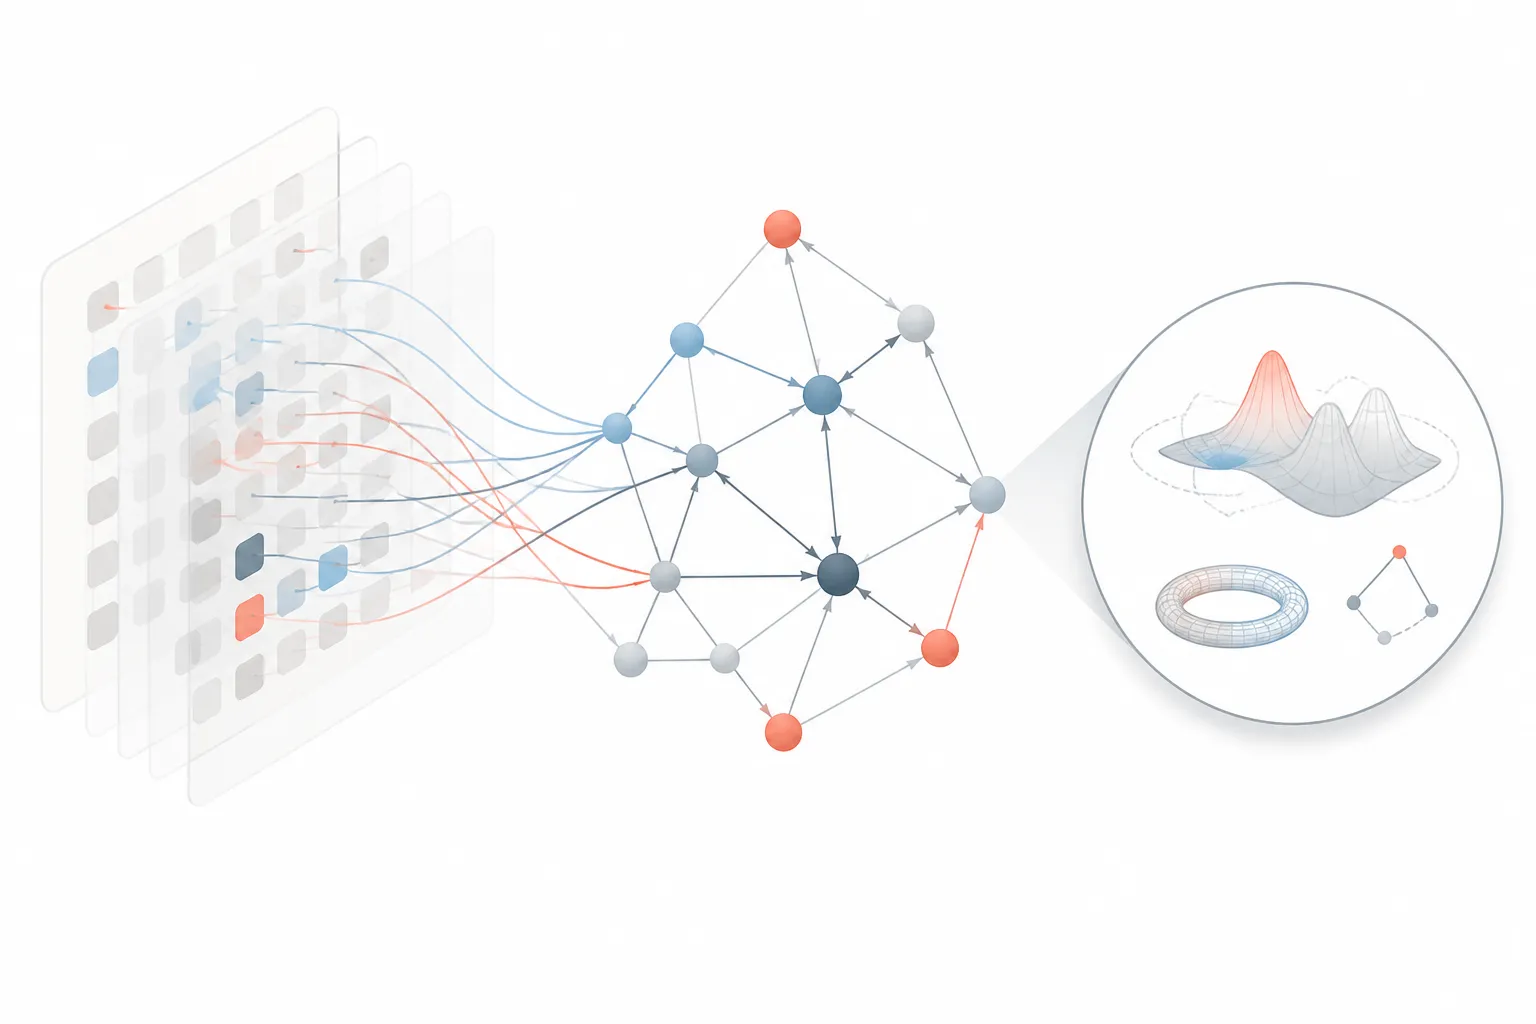
Nei transformer, l’attenzione assegna un peso alle relazioni tra i token elaborati dal modello. Questi pesi possono essere organizzati come un grafo: i token diventano nodi, mentre le connessioni di attenzione formano archi pesati. La struttura risultante permette di osservare come l’informazione si distribuisce, quali elementi concentrano maggiormente il flusso e dove possono crearsi strozzature.
Il metodo descritto nel paper utilizza diverse caratteristiche topologiche ricavate dalle mappe di attenzione. Tra queste compare la curvatura di Forman-Ricci, una misura applicata ai grafi per descrivere l’organizzazione locale delle connessioni e individuare possibili fenomeni di concentrazione o dispersione del flusso informativo.
Gli autori associano le risposte allucinate a tre configurazioni ricorrenti: una dipendenza eccessiva dalla self-attention, un recupero diffuso del contesto dai token precedenti e un fenomeno definito information over-squashing. Quest’ultimo si verifica quando una quantità ampia di informazioni deve attraversare un numero limitato di connessioni, con il rischio che dettagli rilevanti vengano compressi o perdano influenza sul risultato finale.
I segnali più evidenti emergerebbero soprattutto nell’ultimo layer del transformer, vicino alla produzione della risposta. La capacità del modello di mantenere e integrare il contesto può quindi essere studiata osservando la forma assunta dalla rete di relazioni interne in questa fase avanzata dell’elaborazione.
Le caratteristiche più utili
Tra le misure esaminate, il lavoro attribuisce particolare utilità all’outgoingness semi-locale e all’entropia globale dell’attenzione. La prima sintetizza il modo in cui l’informazione si distribuisce attraverso le connessioni in uscita in una determinata area del grafo. La seconda descrive quanto l’attenzione risulti concentrata oppure dispersa nell’insieme della struttura.
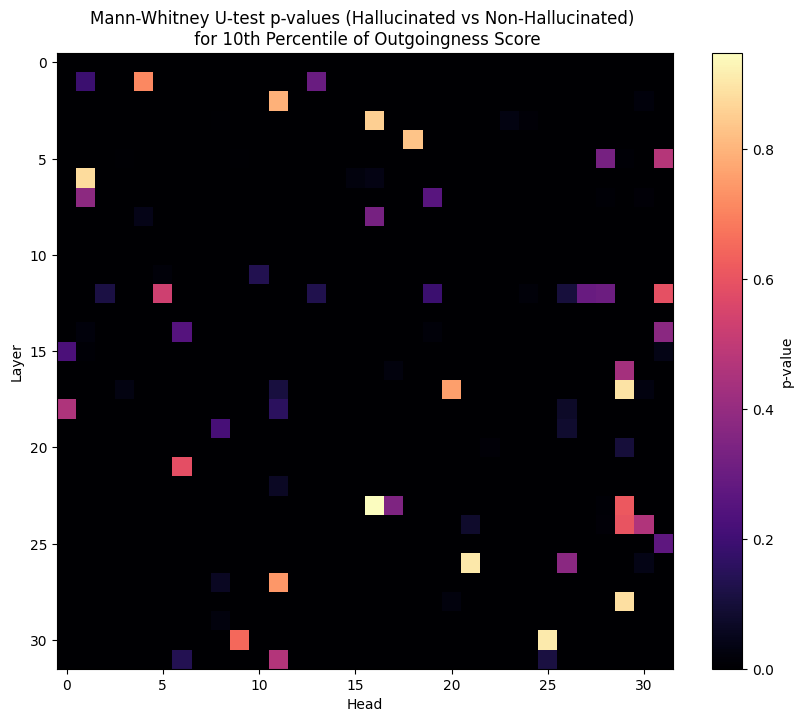
L’aggiunta di caratteristiche topologiche più fini non produce sempre incrementi significativi. Questa osservazione ha una possibile conseguenza operativa: un rilevatore efficace potrebbe basarsi su un insieme relativamente compatto di segnali, evitando una crescita eccessiva della complessità. La sostenibilità computazionale di un’eventuale implementazione resta comunque da misurare in condizioni reali.
I risultati sui modelli esaminati
La valutazione comprende Mistral 7B Instruct, LLaMA 3.1 8B Instruct, Phi-4 e Qwen3-32B. Gli esperimenti utilizzano due temperature di campionamento, 0,1 e 1,0, così da osservare il comportamento del metodo in configurazioni di generazione differenti. I benchmark considerati sono TruthfulQA e NQOPEN, mentre il confronto include baseline come gli autovalori del laplaciano ed EigenScore.
Il metodo opera in modalità single-pass: il rilevamento viene effettuato analizzando una singola elaborazione, senza fondarsi necessariamente sulla generazione ripetuta di numerose risposte. Gli autori riportano miglioramenti consistenti nei due benchmark e un guadagno medio di circa 3,4 punti AUC rispetto alle baseline selezionate.
L’AUC misura la capacità di distinguere due classi attraverso diverse soglie decisionali. Il miglioramento riportato descrive quindi una separazione più efficace tra risposte corrette e allucinate nel perimetro sperimentale scelto. Non indica la percentuale di risposte automaticamente corrette, né permette da solo di stimare le prestazioni in ogni applicazione.
Qwen3-32B ottiene i risultati più deboli nel set-up del paper. Gli autori ipotizzano che il reasoning articolato in più passaggi possa influire sulla forma dei segnali osservati. L’interpretazione richiede ulteriori verifiche, perché modelli con architetture e strategie di ragionamento differenti possono organizzare il contesto in modi non pienamente sovrapponibili.
Dalla ricerca ai controlli di qualità
Un rilevatore di questo tipo potrebbe affiancare i sistemi di valutazione usati durante lo sviluppo dei modelli. La diagnosi interna consentirebbe di segnalare le risposte nelle quali il flusso del contesto assume configurazioni associate a una maggiore probabilità di allucinazione. Il segnale potrebbe poi attivare una verifica documentale, una nuova elaborazione o la revisione umana.
Le applicazioni più interessanti riguardano i processi in cui gli LLM lavorano su conoscenze verificabili, come assistenti documentali, strumenti editoriali e sistemi di ricerca aziendale. In questi ambienti, un indicatore topologico potrebbe entrare in una pipeline composta anche dal controllo delle citazioni e dal confronto con archivi affidabili.
L’implementazione diretta richiederebbe accesso alle mappe di attenzione o a informazioni interne equivalenti. Questa condizione rende il metodo più immediatamente adatto alla ricerca, alla valutazione di modelli aperti e alle infrastrutture controllate dagli sviluppatori. L’uso attraverso servizi chiusi dipenderebbe dalla disponibilità delle informazioni tecniche necessarie.
I limiti ancora da verificare
Il lavoro è un preprint e i risultati non hanno ancora ricevuto una validazione peer-reviewed o una replicazione indipendente. Le prestazioni dipendono inoltre dai benchmark, dai modelli e dalle configurazioni considerate. Serviranno test su domini diversi e su compiti più vicini agli impieghi professionali per capire quanto i segnali restino stabili.
Gli stessi autori richiamano alcuni possibili fattori confondenti. Una strozzatura nel flusso informativo può dipendere da un autentico passaggio semantico complesso, da una lacuna nelle conoscenze del modello oppure dagli attention sink, token che attirano una quantità elevata di attenzione per ragioni legate all’architettura. Distinguere queste situazioni è essenziale per limitare segnalazioni imprecise.
Il contributo più interessante consiste nell’osservare l’allucinazione come un fenomeno legato anche alla circolazione interna del contesto. Se questa relazione verrà confermata su scala più ampia, i grafi di attenzione potranno offrire nuovi strumenti diagnostici per costruire controlli di qualità più tempestivi. Il percorso resta sperimentale, con una direzione concreta: integrare la verifica dell’output con misure capaci di descrivere come il modello è arrivato alla propria risposta.
Fonti