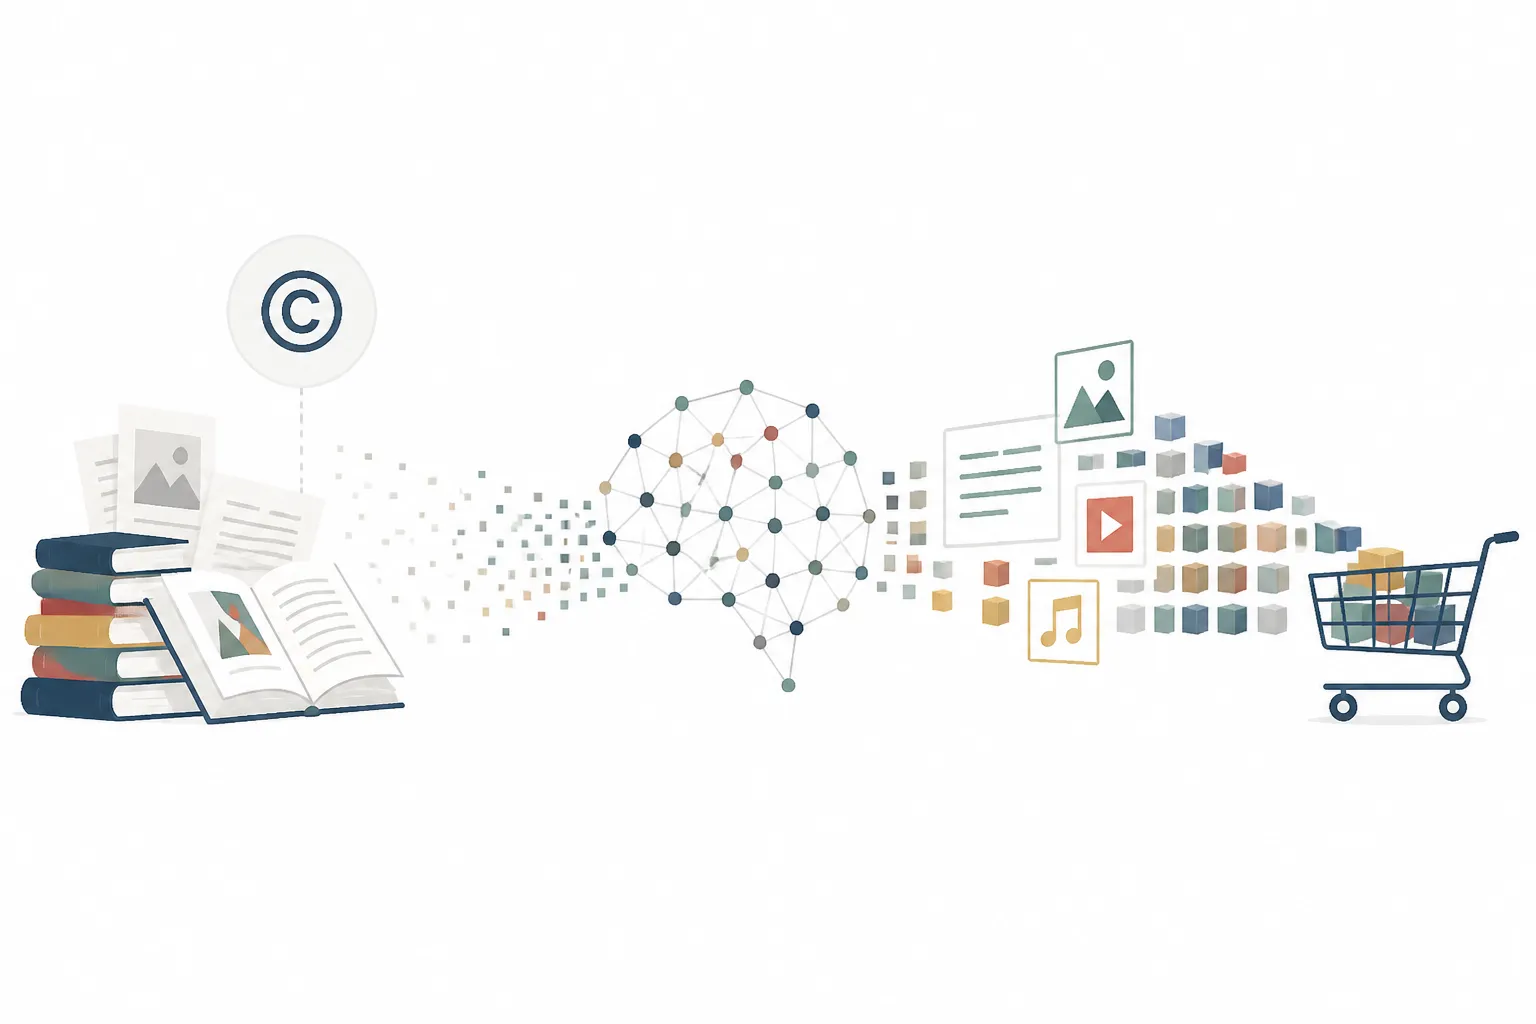
Le eccezioni per il text and data mining regolano l’uso delle opere durante l’addestramento. La valutazione dei servizi generativi richiede anche di capire quale domanda soddisfano e come incidono sul mercato dei contenuti protetti.
La diffusione dell’intelligenza artificiale generativa sta ampliando il perimetro del confronto sul copyright. L’attenzione si è concentrata a lungo sui dati usati per addestrare i modelli, sull’accesso alle opere e sulle eccezioni previste per l’analisi automatizzata dei contenuti. Con la crescita dei servizi commerciali diventa altrettanto rilevante osservare ciò che questi sistemi producono e la funzione economica svolta dagli output.
Per editori, autori e piattaforme, la questione riguarda la relazione tra opere protette, prodotti generati e domanda di mercato. Un output può essere privo di riproduzioni letterali evidenti e, allo stesso tempo, offrire agli utenti una funzione vicina a quella di un contenuto editoriale, di un’immagine concessa in licenza o di un servizio professionale fondato su materiali protetti. Questa vicinanza funzionale non determina automaticamente una violazione, però entra nella valutazione giuridica ed economica del prodotto.
Le diverse fasi di un sistema generativo
Una valutazione accurata richiede di distinguere le operazioni che compongono il funzionamento di un sistema di AI. L’acquisizione delle opere nel dataset, l’addestramento, l’eventuale recupero di documenti durante una richiesta e la produzione della risposta sono condotte differenti. Possono coinvolgere soggetti, copie, basi giuridiche e finalità diverse.
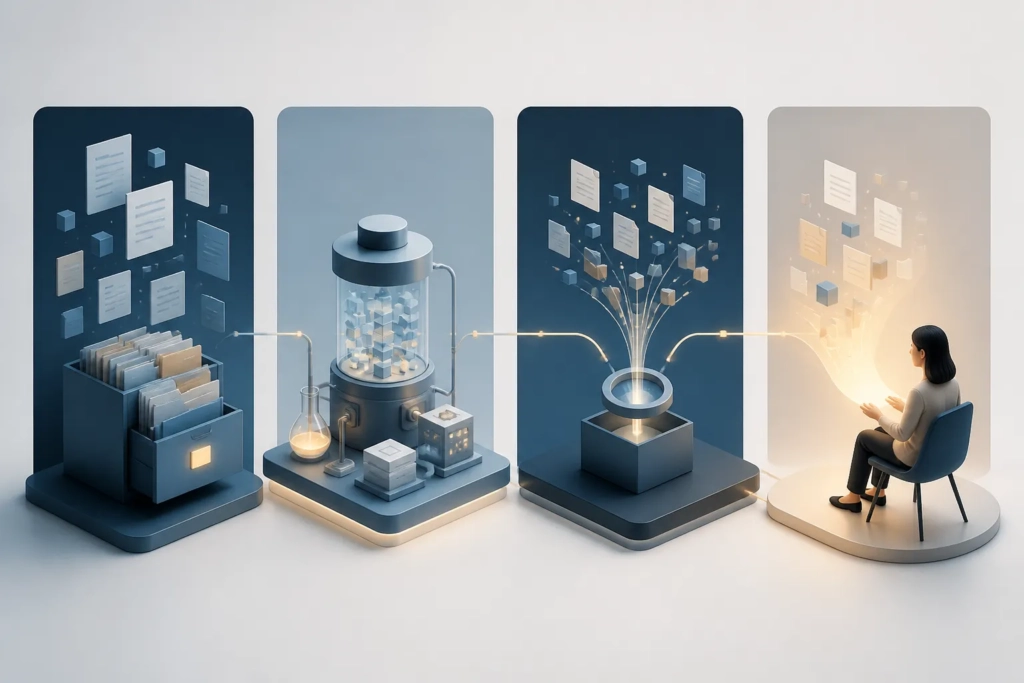
Durante la costruzione di un dataset, per esempio, possono verificarsi riproduzioni o estrazioni necessarie all’analisi automatizzata. Nell’addestramento, i dati vengono elaborati per modificare i parametri del modello. Nei sistemi dotati di retrieval, documenti specifici possono essere recuperati al momento della richiesta e forniti al modello come contesto. L’output costituisce infine il risultato reso disponibile all’utente, eventualmente all’interno di un servizio a pagamento.
Trattare queste fasi come un’unica attività rende più difficile individuare la disciplina applicabile. La liceità dell’accesso iniziale non risolve da sola le domande relative al recupero successivo delle opere, alla forma delle risposte e alla commercializzazione del servizio. Allo stesso modo, le caratteristiche di un singolo output non consentono di ricostruire automaticamente le condizioni nelle quali è stato realizzato il dataset.
Il quadro europeo sul text and data mining
Nell’Unione europea, la direttiva 2019/790 disciplina specificamente il text and data mining, cioè l’analisi automatizzata di grandi quantità di testi e dati. Gli articoli 3 e 4 prevedono eccezioni distinte per queste attività. Nel caso generale, che comprende gli utilizzi commerciali, i titolari possono riservare i propri diritti secondo le condizioni previste dalla direttiva.
La riserva dei diritti assume quindi una funzione operativa nel rapporto tra produttori di contenuti e sviluppatori di modelli. La sua applicazione richiede procedure riconoscibili, documentabili e compatibili con il modo in cui le opere vengono distribuite online. Per gli operatori dell’AI diventa importante conservare informazioni sulla provenienza dei materiali, sulle condizioni di accesso e sulle autorizzazioni disponibili.
In Italia, la legge 23 settembre 2025, n. 132 ha introdotto l’articolo 70-septies nella disciplina nazionale. La disposizione riguarda riproduzioni ed estrazioni da opere o altri materiali legittimamente accessibili per finalità di text and data mining tramite modelli e sistemi di AI, compresi quelli generativi. La norma inserisce esplicitamente queste tecnologie nel quadro nazionale, senza trasformare l’eccezione relativa all’analisi dei dati in un’autorizzazione generale per ogni uso successivo.
Perché conta il mercato degli output
Il mercato diventa rilevante quando un servizio generativo intercetta la domanda normalmente soddisfatta da opere, licenze o prodotti editoriali esistenti. Un sistema capace di fornire una sintesi sostitutiva, generare un contenuto visivo destinato allo stesso impiego o restituire informazioni tratte da una raccolta professionale può incidere sulle opportunità economiche dei titolari.
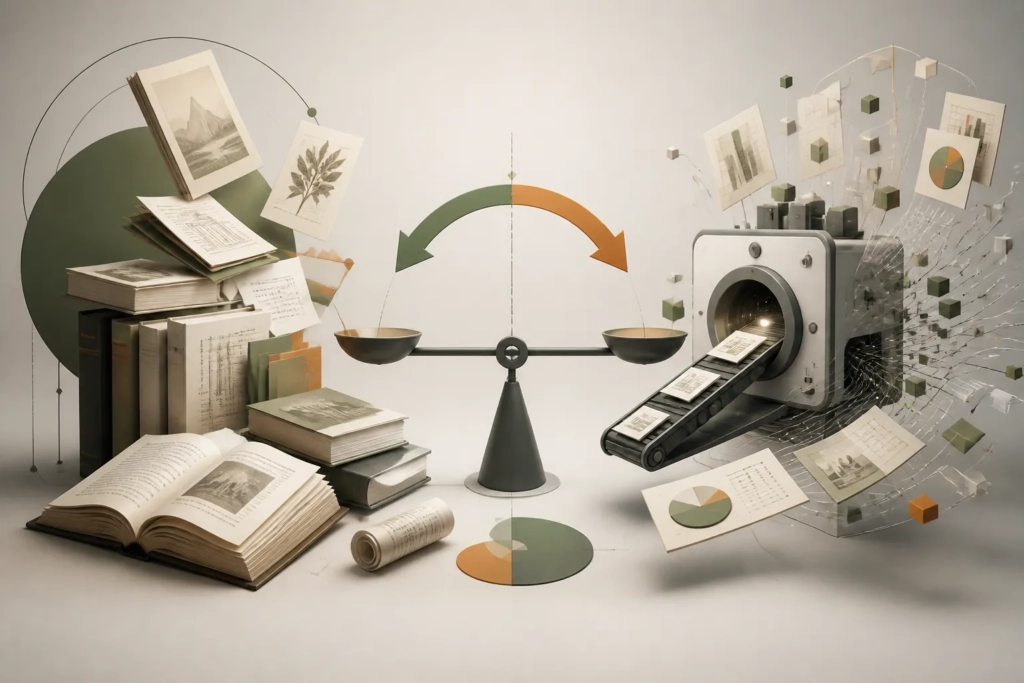
La concorrenza funzionale, considerata isolatamente, non decide la liceità di un servizio. Occorre esaminare il quadro normativo applicabile, le modalità con cui le opere sono state utilizzate, le caratteristiche degli output e l’eventuale riproduzione di elementi protetti. L’impatto sul mercato acquista particolare rilievo quando si collega a un uso delle opere capace di ridurre la domanda per gli originali o per le relative licenze.
Questa impostazione è particolarmente visibile negli Stati Uniti. Tra i fattori del fair use, il quarto considera l’effetto dell’uso sul mercato potenziale e sul valore dell’opera protetta. Il precedente Thomson Reuters v. Ross offre un riferimento utile per discutere il rapporto tra impiego di materiali protetti, prodotti concorrenti e finalità commerciali. Rimane un caso legato a circostanze specifiche e non fornisce una soluzione automaticamente trasferibile a ogni modello generativo.
La cornice europea segue una struttura diversa, fondata su diritti esclusivi ed eccezioni definite dalla normativa. Per questo, concetti provenienti dal fair use statunitense non possono essere applicati direttamente alle controversie europee. L’analisi del mercato conserva comunque valore per comprendere gli effetti concreti di un prodotto e per valutare licenze, accordi e modelli di remunerazione.
Le conseguenze per editori e sviluppatori
Per le imprese editoriali, la tutela dei contenuti richiede una gestione più strutturata dei diritti digitali. Diventa utile identificare quali archivi possano essere analizzati, quali opere siano disponibili tramite licenza e quali riserve debbano essere comunicate. Serve inoltre osservare i servizi che utilizzano retrieval o generazione automatica, distinguendo una citazione occasionale da un prodotto progettato per soddisfare stabilmente la stessa esigenza del contenuto originario.
Gli sviluppatori possono ridurre l’incertezza separando con chiarezza le fasi tecniche del proprio sistema. La documentazione sulla provenienza dei dati, le regole di accesso alle fonti e i controlli sugli output aiutano a ricostruire il processo. Nei prodotti rivolti a mercati professionali, questa tracciabilità può diventare una caratteristica essenziale quanto le prestazioni del modello.
Anche la progettazione dell’esperienza utente ha conseguenze concrete. Un assistente che rimanda alle opere, limita la quantità di contenuto recuperato e opera entro accordi di licenza ha un profilo differente da un servizio che consegna sistematicamente risultati destinati a sostituire l’accesso alle fonti. Le differenze tecniche e commerciali devono emergere nella valutazione complessiva.
Licenze e nuovi modelli di collaborazione
L’attenzione agli output può favorire accordi più precisi tra titolari e imprese tecnologiche. Le licenze possono disciplinare separatamente l’addestramento, il recupero dei documenti e la generazione di prodotti destinati agli utenti finali. Questa articolazione permette di collegare la remunerazione all’uso effettivo e alla funzione economica svolta dal sistema.
Per autori, editori e piccole imprese creative, la capacità di descrivere e documentare il proprio catalogo diventa parte della strategia digitale. Metadati affidabili, condizioni d’uso leggibili e archivi organizzati facilitano sia l’esercizio dei diritti sia la partecipazione a servizi autorizzati. Per le aziende di AI, accordi chiari possono offrire accesso a contenuti di qualità e ridurre le ambiguità lungo la filiera.
Il dibattito sul copyright entra così in una fase più concreta. Accesso ai dati, addestramento, retrieval e output devono essere valutati con strumenti distinti, tenendo insieme diritto e funzionamento dei prodotti. La sostenibilità dei servizi generativi dipenderà sempre più dalla capacità di innovare rispettando il valore economico delle opere e costruendo relazioni trasparenti con chi le produce.
Fonti
- AI e opere protette: il confine si sposta dal training al mercato
- Direttiva (UE) 2019/790 – EUR-Lex
- Legge 23 settembre 2025, n. 132 – Normattiva