Il modello di Google occupa la prima posizione nella Text Arena dedicata alla creative writing, con un risultato preliminare molto vicino a quello di Claude Opus 5.5.
Gemini 4 Argon occupa la prima posizione nella classifica Text Arena dedicata alla scrittura creativa. Nella rilevazione aggiornata al 2 ottobre 2026, il modello identificato come gemini-4-argon-high raggiunge un punteggio di 1519±19, calcolato sulla base di 1.097 voti. Il risultato è contrassegnato come preliminare, quindi la posizione potrà cambiare con l’arrivo di nuove valutazioni.
La graduatoria offre una fotografia delle capacità dei modelli di intelligenza artificiale in un ambito specifico: la produzione di testi creativi. Al momento della rilevazione raccoglie 1.369.042 voti e comprende 411 modelli, provenienti da aziende come Google, Anthropic, OpenAI, Meta, Alibaba, Z.ai, Xiaomi, DeepSeek e xAI. L’ampiezza del campione rende la pagina utile per osservare l’evoluzione del settore, tenendo presente la natura dinamica dei risultati.
Un vantaggio numerico ancora ridotto
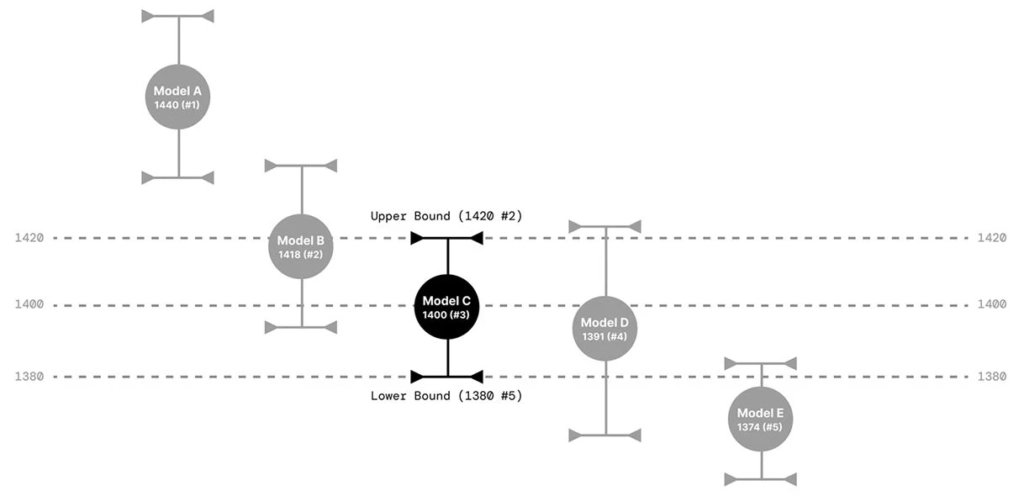
La distanza tra i primi due modelli è contenuta. Subito dopo Gemini 4 Argon compare claude-opus-5.5-high, con un punteggio di 1516±20 e 1.058 voti. Tre punti separano quindi le due prime posizioni, mentre gli intervalli associati ai punteggi risultano ampiamente sovrapposti.
Questa vicinanza invita a leggere il primato di Gemini 4 Argon come una posizione provvisoria all’interno di un confronto molto equilibrato. La metodologia di Arena accompagna i risultati con intervalli di confidenza e indicazioni sulla possibile estensione del rango, strumenti che aiutano a evitare interpretazioni eccessivamente rigide. Una prima posizione comunica il risultato ottenuto in quel momento; la sovrapposizione degli intervalli indica che la superiorità rispetto al concorrente più vicino non può essere considerata definitiva.
Anche il numero dei voti ricevuti dai singoli modelli conta. Poco più di mille valutazioni costituiscono una base significativa per una prima lettura, pur lasciando spazio a variazioni quando il campione cresce. L’etichetta “Preliminary” associata a Gemini 4 Argon rende esplicita questa condizione.
Che cosa misura la classifica di scrittura creativa
La Text Arena Creative Writing concentra l’attenzione sulla generazione testuale in compiti creativi. Il risultato riguarda quindi la capacità di produrre testi apprezzati nel perimetro di questa particolare leaderboard. È una misura mirata, distinta da valutazioni dedicate al ragionamento, alla programmazione, all’analisi documentale o all’uso di strumenti esterni.
Per autori, editor e professionisti dei contenuti, la specializzazione del benchmark è particolarmente interessante. La qualità della scrittura assistita dipende da caratteristiche difficili da riassumere in un singolo numero: coerenza narrativa, controllo del tono e capacità di seguire vincoli stilistici. Una classifica basata su valutazioni aggregate può indicare quali modelli incontrano più spesso le preferenze degli utenti, senza sostituire una prova condotta sui materiali e sui flussi di lavoro reali.
Un modello efficace nella scrittura creativa può risultare utile nella preparazione di una prima bozza, nell’esplorazione di varianti narrative o nella riscrittura di un passaggio. Il lavoro editoriale richiede poi verifiche ulteriori, soprattutto quando entrano in gioco continuità tra capitoli, voce dell’autore e coerenza con un progetto già avviato. La classifica aiuta a restringere il campo dei modelli da provare; la scelta operativa richiede test costruiti sulle esigenze concrete.
Il significato dei dati su prezzo e contesto
La scheda di gemini-4-argon-high riporta una coppia di valori di prezzo pari a 2 e 10 dollari e un contesto indicato come 1M. Per claude-opus-5.5-high compaiono rispettivamente 4 e 20 dollari, insieme allo stesso valore di contesto. Questi dati aggiungono una dimensione pratica al confronto, perché la qualità di generazione viene affiancata da informazioni utili a valutare l’impiego del modello.
Il contesto esteso può avere ricadute rilevanti nella scrittura. Una finestra ampia permette, in linea generale, di includere più materiale durante una sessione: documentazione di progetto, capitoli precedenti o indicazioni stilistiche. La disponibilità di spazio non garantisce da sola una gestione perfetta di ogni dettaglio. Offre comunque una base tecnica favorevole per attività che coinvolgono testi lunghi e numerosi riferimenti.
Anche il prezzo deve essere interpretato in relazione al tipo di utilizzo. La coppia di valori mostrata dalla leaderboard suggerisce per Gemini 4 Argon un livello inferiore rispetto a Claude Opus 5.5 nelle configurazioni indicate. Il costo finale di un flusso editoriale dipende dal volume dei testi, dalla frequenza delle revisioni e dal numero di passaggi necessari per ottenere un risultato utilizzabile. Un modello leggermente più costoso può restare conveniente quando riduce le iterazioni; un’opzione più economica può risultare preferibile per produzioni ampie e ripetitive.
Come valutare Gemini 4 Argon in un flusso editoriale
Il primo posto nella Creative Writing Arena rende Gemini 4 Argon un candidato naturale per prove dedicate alla scrittura assistita. Un test utile dovrebbe riprodurre il lavoro quotidiano anziché limitarsi a richieste generiche. Si possono confrontare, per esempio, la stesura di un’apertura, la riscrittura con un tono definito e il mantenimento della coerenza in un testo lungo.
È opportuno usare gli stessi prompt e gli stessi materiali per tutti i modelli coinvolti. La valutazione può considerare la quantità di interventi necessari, la fedeltà alle istruzioni e la stabilità del registro. Per i contenuti in italiano assume rilievo anche la naturalezza della lingua, perché una classifica internazionale può riflettere preferenze aggregate che non coincidono pienamente con quelle di una redazione italiana.
Questo approccio permette di trasformare il benchmark in una selezione operativa. Il punteggio iniziale orienta la scelta dei candidati, mentre il test interno chiarisce quale modello si adatta meglio alla produzione di articoli, materiali formativi o testi narrativi. Le differenze più utili possono emergere nella revisione: gestione delle ripetizioni, precisione delle modifiche e capacità di rispettare una struttura senza appiattire lo stile.
Una competizione sempre più vicina alle esigenze degli autori
La presenza di centinaia di modelli e di numerosi fornitori mostra quanto la generazione testuale sia diventata competitiva. Le leaderboard specializzate consentono di osservare capacità legate a un’attività concreta, superando le valutazioni troppo generiche della qualità complessiva. Per il settore editoriale, questa segmentazione rende i confronti più leggibili e più vicini alle decisioni quotidiane.
Gemini 4 Argon emerge oggi come il modello con il punteggio più alto nella scrittura creativa della Text Arena. Il margine ridotto su Claude Opus 5.5 e lo stato preliminare suggeriscono una lettura prudente. Il dato più rilevante riguarda la maturazione degli strumenti: i modelli di vertice possono essere confrontati attraverso qualità percepita, costi indicati e capacità di gestire contesti estesi.
Per autori e professionisti dei contenuti, la classifica offre quindi una base per decidere quali sistemi sperimentare. La prova decisiva resta quella condotta sui propri testi, con criteri coerenti e risultati verificabili. In questo percorso, il primato provvisorio di Gemini 4 Argon costituisce un’indicazione concreta da approfondire attraverso l’uso.
Fonti
- LLM Leaderboard – Best Text & Chat AI Models Compared | Text Arena Creative Writing
- Arena's Ranking Method