

Il nuovo opt-out in robots.txt sarà supportato nei prossimi mesi. Restano validi i controlli esistenti: per gli editori è una gestione delle preferenze, non un blocco universale degli accessi.
OpenAI ha annunciato che rispetterà un segnale comune nel file robots.txt attraverso il quale i gestori dei siti potranno esprimere le proprie preferenze sull’uso dei contenuti per l’addestramento dei modelli generativi di base. L’obiettivo è rendere più semplice comunicare questa scelta a più fornitori di intelligenza artificiale, riducendo la necessità di gestire indicazioni separate per ciascun operatore.
L’annuncio, pubblicato il 30 ottobre 2026, prevede un’implementazione nei prossimi mesi. I controlli sui crawler già supportati da OpenAI continueranno a funzionare e il nuovo segnale si aggiungerà alle regole esistenti. Chi amministra un sito può quindi continuare a utilizzare gli strumenti disponibili, senza considerare il nuovo meccanismo un sostituto immediato delle configurazioni attuali.
La distinzione è importante per comprendere la portata dell’iniziativa. Il segnale riguarda le preferenze sull’addestramento: il suo scopo è permettere a un editore di dichiarare come desidera che vengano trattati i propri contenuti per quella specifica finalità. L’accesso automatizzato a una pagina e il successivo impiego dei dati sono aspetti collegati, da valutare separatamente.
Per chi pubblica sul web, la conseguenza più interessante è la possibilità di esprimere una scelta attraverso un meccanismo condiviso. Un sito può avere interesse a rendere facilmente reperibili i propri articoli e, contemporaneamente, voler gestire in modo distinto il loro utilizzo nell’addestramento. La precisione dei controlli conta proprio perché consente di avvicinare le impostazioni tecniche alle decisioni editoriali.
Robots.txt è un file di testo collocato nella directory principale di un sito. Contiene indicazioni rivolte ai programmi che visitano automaticamente le pagine, i cosiddetti crawler. Questi strumenti raccolgono informazioni per finalità diverse: il file permette al gestore di comunicare quali percorsi siano accessibili e quali restrizioni debbano essere rispettate dai programmi interessati.
Il suo funzionamento è dichiarativo. Le regole vengono lette e applicate dai crawler che scelgono di rispettarle; il file, da solo, non costituisce una barriera tecnica contro ogni richiesta. Questa caratteristica vale anche quando robots.txt viene impiegato per comunicare preferenze relative all’AI. La sua utilità dipende dall’adesione dei fornitori e dalla corretta applicazione delle indicazioni.
OpenAI descrive il nuovo segnale come volontario e invita altri provider a rispettarlo. Un’indicazione comune può semplificare il lavoro dei gestori, soprattutto quando un archivio viene consultato da numerosi servizi. La stessa scelta potrebbe così essere comunicata a più operatori aderenti, con un minore carico di configurazione e manutenzione.
Il tema si inserisce in un quadro nel quale esistono già controlli legati ai singoli fornitori. Microsoft dichiara di rispettare standard come robots.txt per consentire ai publisher di escludere il web crawling. Google richiama strumenti analoghi e il controllo Google-Extended. Queste soluzioni mostrano l’importanza attribuita alle preferenze dei siti, pur richiedendo attenzione al perimetro specifico di ciascun meccanismo.
Una comunicazione condivisa potrebbe rendere più ordinata questa gestione. Per un piccolo editore, seguire l’evoluzione dei diversi crawler comporta un’attività continuativa: occorre capire a quale servizio appartengano, quali finalità abbiano e quali regole riconoscano. Ridurre la frammentazione delle preferenze può alleggerire una parte di questo lavoro, lasciando comunque necessaria la verifica delle impostazioni.
Per una redazione digitale, la prima decisione resta quindi editoriale. Occorre stabilire quale politica applicare ai contenuti prima di tradurla in una configurazione tecnica. Un archivio di articoli, un catalogo commerciale e un’area riservata possono avere esigenze differenti. La scelta sull’addestramento dovrebbe essere coerente con il modo in cui ciascuna organizzazione distribuisce e valorizza il proprio patrimonio informativo.
Un esempio è quello di una testata che desidera mantenere pubblici i propri approfondimenti e comunicare una preferenza contraria al loro impiego nell’addestramento. Il nuovo segnale è pensato per esprimere quest’ultima scelta ai fornitori che lo supportano. L’effetto sugli altri servizi va valutato attraverso le rispettive regole, evitando di estendere automaticamente una configurazione a qualsiasi uso dei contenuti.
La distinzione serve anche alle imprese che pubblicano documentazione o materiali formativi. Avere un sito accessibile rende i contenuti consultabili, mentre la politica sul loro utilizzo nei sistemi AI richiede una decisione specifica. Un meccanismo condiviso offre un modo più semplice per comunicarla, a condizione che l’organizzazione sappia quali risultati intende ottenere.
Sul piano operativo, il passaggio più utile è una ricognizione delle regole già presenti. Chi gestisce il sito dovrebbe sapere quali crawler sono autorizzati, quali sezioni risultano escluse e chi ha la responsabilità di aggiornare il file. La continuità dei controlli esistenti permette di affrontare l’introduzione del nuovo segnale senza presumere che tutte le impostazioni precedenti debbano essere riscritte.
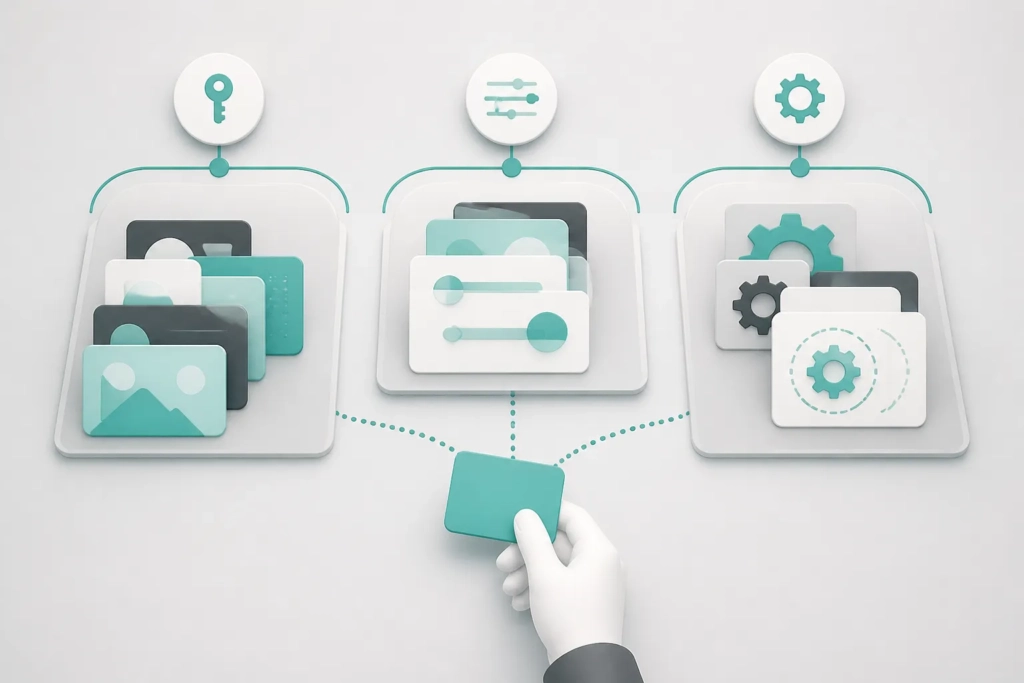
La configurazione richiede inoltre attenzione all’identità dei crawler. I programmi riconducibili a una stessa azienda possono svolgere funzioni differenti: prima di applicare una regola è opportuno verificare quale attività copra. Una scelta troppo ampia rispetto all’obiettivo editoriale potrebbe incidere anche su forme di accesso che il gestore desidera conservare.
Quando l’esigenza riguarda il contenimento delle richieste o la protezione dell’accesso, entrano in gioco strumenti diversi. Le limitazioni del traffico possono ridurre il numero di richieste ricevute; l’autenticazione può riservare determinate pagine agli utenti abilitati. Queste misure agiscono sull’accesso e comportano conseguenze proprie per l’esperienza dei lettori, da valutare separatamente dalle preferenze sull’addestramento.
Per editori e professionisti dei contenuti, la prospettiva più concreta è una maggiore chiarezza nei rapporti con i servizi AI. Il valore di un segnale comune dipenderà dalla diffusione del supporto e dalla coerenza con cui verrà applicato. Un’adesione più ampia potrebbe rendere le scelte dei publisher più facili da comunicare e mantenere nel tempo.
L’iniziativa di OpenAI aggiunge dunque un canale condiviso a strumenti già disponibili. Nei prossimi mesi sarà importante seguirne l’implementazione e verificare come si affiancherà alle configurazioni esistenti. Per chi pubblica sul web, il criterio resta concreto: definire le preferenze sull’uso dei propri contenuti, scegliere controlli coerenti e distinguere sempre una dichiarazione destinata ai crawler da una restrizione tecnica dell’accesso.
Fonti
- ‘We believe this is a practical step toward an open web’: Don't want AI companies training on your website? OpenAI, Google and Microsoft are backing a new way to opt out | TechRadar
- OpenAI – Making it easier for websites to express AI training preferences
- Microsoft Trust Center – Data for AI Training

