

Il progetto basato su vLLM apre agli sviluppatori una parte dello stack di esecuzione del modello, con possibili effetti su efficienza, costi e automazione dei servizi AI.
DeepSeek ha pubblicato DeepInfer, un framework open source progettato per eseguire i propri modelli di intelligenza artificiale con prestazioni elevate e su larga scala. Il codice è distribuito con licenza Apache 2.0 e il primo checkpoint supportato è DeepSeek-V4.1-Flash-1017, la versione del modello che l’azienda presenta come più veloce ed efficiente.
Il rilascio porta l’attenzione su una componente meno visibile rispetto al modello linguistico, eppure decisiva per l’esperienza finale: il sistema che gestisce l’inferenza. È in questa fase che un modello già addestrato riceve una richiesta, elabora i token e genera una risposta. La qualità del software impiegato incide sulla velocità, sulla memoria richiesta, sul numero di utenti servibili e, di conseguenza, sul costo operativo di un’applicazione AI.
DeepInfer rende accessibile una parte di questo livello tecnologico. Sviluppatori, aziende e gruppi di ricerca possono esaminarne il funzionamento, adattarlo alle proprie infrastrutture e verificare direttamente i risultati nelle configurazioni hardware disponibili. La licenza scelta consente inoltre un riuso ampio del progetto, nel rispetto dei relativi termini.
Un framework costruito sull’ecosistema vLLM
DeepInfer è sviluppato principalmente a partire da vLLM, uno dei progetti open source più diffusi per l’esecuzione efficiente dei modelli linguistici. Il repository cita anche SGLang e TensorRT-LLM come fonti di ispirazione. Questa base colloca il progetto in un ecosistema già conosciuto da molti sviluppatori e facilita il confronto con strumenti impiegati per distribuire modelli su GPU.
Tra le funzionalità disponibili figura lo scheduling asincrono, utile per organizzare più richieste senza costringere il sistema ad attendere il completamento sequenziale di ogni operazione. Una gestione efficace delle code può aumentare l’utilizzo delle risorse di calcolo e ridurre i tempi di inattività dell’hardware.
Il framework supporta anche gli output strutturati. Un modello può quindi essere guidato a restituire informazioni in un formato definito, ad esempio un oggetto JSON o una struttura compatibile con un’applicazione. Questa caratteristica è rilevante nei flussi automatizzati, dove la risposta deve essere letta da un altro software per aggiornare un archivio, compilare una scheda o avviare un’azione successiva.
DeepInfer comprende inoltre modalità di inferenza deterministica e invarianti rispetto al batch in configurazioni specifiche. L’obiettivo è rendere l’esecuzione più prevedibile quando le richieste vengono elaborate insieme ad altre. La riproducibilità può essere importante nei test, nelle valutazioni interne e nei processi aziendali che richiedono risultati coerenti a parità di condizioni.
Che cosa manca per un servizio completo
La pubblicazione non equivale a una piattaforma online pronta per essere installata e aperta immediatamente a migliaia di utenti. Il progetto si concentra per ora sull’inferenza offline del checkpoint supportato e lascia fuori alcune componenti necessarie per costruire un servizio completo.
Tra gli elementi ancora mancanti DeepSeek indica un sistema dedicato alla KV cache, la separazione tra le fasi di prefill e decode e il bilanciamento del carico fra repliche data-parallel. Sono componenti tecniche che acquistano particolare importanza quando molte persone interrogano contemporaneamente lo stesso modello.
La KV cache conserva le informazioni già elaborate durante la generazione di una risposta, evitando di ripetere parte dei calcoli a ogni nuovo token. La gestione di questa memoria influenza direttamente la quantità di richieste che può essere mantenuta attiva su una GPU. La disaggregazione di prefill e decode permette invece di assegnare a risorse diverse la lettura iniziale del prompt e la successiva produzione della risposta. Il bilanciamento del carico distribuisce infine le richieste tra più repliche del modello.
DeepInfer va quindi considerato come una base tecnica specializzata, già utile per sperimentazione e inferenza offline. La costruzione di un’API affidabile richiede ulteriori servizi di orchestrazione, monitoraggio e gestione dell’infrastruttura.
Il legame con DeepSeek-V4.1-Flash
Il framework è strettamente collegato a DeepSeek-V4.1-Flash. Per questo modello l’azienda introduce una nuova architettura definita Causal Encoder–Decoder, progettata per contenere le esigenze della KV cache. Una minore occupazione di memoria può aumentare il margine disponibile per richieste parallele o contesti più estesi, anche se il risultato effettivo dipende dall’hardware, dalla configurazione e dal tipo di carico.
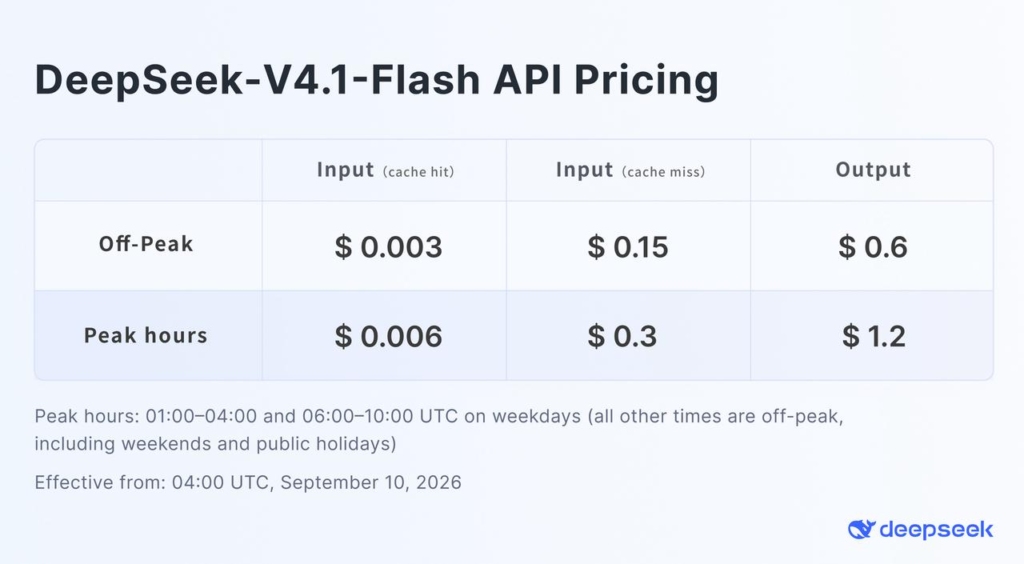
DeepSeek ha accompagnato il modello con una riduzione dei prezzi della propria API. Il rapporto tra architettura, software di inferenza e listino commerciale evidenzia come la competizione tra servizi AI si stia spostando lungo l’intero stack. Le capacità del modello restano centrali, mentre l’efficienza con cui viene eseguito determina sempre più spesso la sostenibilità economica del servizio.
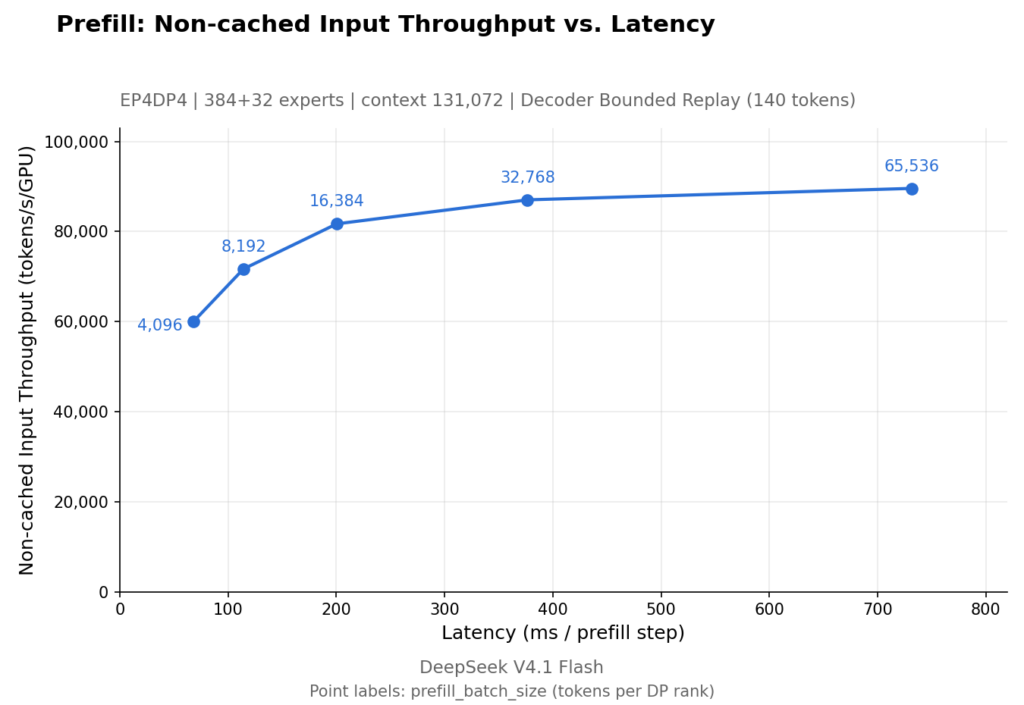
Non sono sufficienti indicazioni generali per stabilire un vantaggio valido in ogni scenario. Velocità, consumo energetico e costo per richiesta cambiano in funzione delle GPU, della lunghezza dei prompt, del numero di utenti simultanei e delle ottimizzazioni applicate. La disponibilità del codice consente però di effettuare verifiche dirette e di confrontare il framework con alternative già presenti sul mercato.
Le conseguenze per sviluppatori e imprese
Per chi sviluppa applicazioni AI, l’interesse di DeepInfer risiede nella possibilità di studiare soluzioni nate attorno a un modello recente e orientato all’efficienza. Un team tecnico può eseguire benchmark sul proprio hardware, analizzare la gestione delle richieste e adattare alcune componenti alle esigenze di un prodotto specifico.
Le piccole e medie imprese potrebbero beneficiare soprattutto degli effetti indiretti. Un’inferenza più efficiente può contribuire a contenere il prezzo delle API e dei servizi gestiti, rendendo più sostenibili strumenti per l’analisi documentale, l’assistenza interna e la produzione di contenuti. L’adozione autonoma del framework richiede comunque competenze specialistiche e infrastrutture adeguate.
Nel settore editoriale e nei flussi dedicati ai contenuti, la prevedibilità dell’output e il supporto ai formati strutturati possono agevolare attività come la classificazione dei materiali, la generazione di metadati e l’estrazione di informazioni. Il valore pratico deriva dall’integrazione con database, sistemi di gestione dei contenuti e procedure di controllo umano.
Una competizione che coinvolge anche l’infrastruttura
L’apertura di DeepInfer amplia il confronto tra gli strumenti disponibili per l’esecuzione dei modelli. La pressione competitiva verso i grandi fornitori internazionali dipenderà dall’adozione del progetto e dai risultati ottenuti in condizioni reali. Il rilascio offre comunque alla comunità un nuovo riferimento tecnico da esaminare, modificare e mettere alla prova.
La scelta di pubblicare il framework mostra anche quanto l’ottimizzazione dell’inferenza sia diventata strategica. Il costo di un servizio di intelligenza artificiale non dipende esclusivamente dall’addestramento iniziale: continua a crescere ogni volta che il modello viene interrogato. Migliorare questa fase può incidere rapidamente sui margini dei provider e sul prezzo pagato dagli utenti.
DeepInfer è ancora una componente parziale rispetto a una piattaforma di produzione completa. Il suo interesse nasce proprio dalla visibilità concessa al livello operativo che collega il modello all’applicazione. Se lo sviluppo proseguirà insieme alla comunità open source, il progetto potrà contribuire a rendere più accessibili le tecniche necessarie per eseguire modelli avanzati con maggiore efficienza.
Fonti
- DeepInfer – GitHub ufficiale DeepSeek
- DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient
- Deepseek open-sources the inference engine that powers its fastest and cheapest AI model

