OpenAI presenta una nuova coppia di modelli per ChatGPT Work, Codex e API. Astra affronta i progetti più impegnativi, Sol cerca il miglior equilibrio per l’uso quotidiano. Al centro del lancio ci sono la qualità dei risultati, l’efficienza e la capacità di accompagnare un’attività attraverso più passaggi, dalla prima richiesta al prodotto utilizzabile.
Una presentazione acquista valore quando permette di capire subito una decisione. Un programma diventa utile quando funziona all’interno del progetto per cui è stato scritto. Un modello tridimensionale serve davvero quando si può osservare, modificare e mettere alla prova. È su questa distanza tra una risposta convincente e un risultato utilizzabile che si concentra il nuovo aggiornamento di OpenAI. Con GPT-6.2 Astra e GPT-6.2 Sol, annunciati il 17 novembre 2026, l’azienda propone due strumenti destinati a intervenire sempre più direttamente nel lavoro.
Astra e Sol: due modelli per esigenze diverse
La distinzione fra i modelli è chiara. Astra è la proposta per le attività più impegnative, nelle quali ragionamento, analisi e coordinamento di diversi passaggi hanno un peso elevato. Sol privilegia l’efficienza nell’impiego quotidiano, compresa la scrittura e la programmazione. La documentazione di lancio suggerisce, per esempio, Astra per ricostruire un guasto distribuito fra più servizi software e Sol per rivedere una modifica al codice. Entrambi appartengono alla stessa generazione, con un diverso equilibrio fra capacità e costo.
Questa impostazione rende più concreta la scelta dell’utente. Preparare una breve comunicazione e analizzare un progetto complesso sono attività con esigenze differenti. Un modello efficiente può seguire buona parte del lavoro corrente, lasciando a quello più potente le fasi nelle quali serve maggiore profondità. Per chi utilizza l’AI durante tutta la giornata, la domanda diventa quindi quale livello di elaborazione assegnare a ciascun compito, tenendo insieme qualità attesa, tempo disponibile e risorse consumate.
Anche l’ambiente di distribuzione aiuta a leggere la notizia. ChatGPT Work è descritto da OpenAI come un agente per attività prolungate e risultati finiti; Codex mantiene una specializzazione nello sviluppo software. La conversazione può così accompagnare la preparazione di un documento o la modifica di un’applicazione, con accesso agli strumenti previsti dall’ambiente. Il modello fornisce le capacità di ragionamento e coordinamento, mentre il prodotto mette a disposizione file, programmi e funzioni operative.
Documenti e presentazioni più vicini al risultato finale
Secondo OpenAI, Astra migliora nella produzione di documenti, presentazioni e fogli di calcolo, aderendo meglio agli standard professionali. È un obiettivo che tocca una parte decisiva dell’esperienza d’uso. Un elaborato destinato a un cliente o a una pubblicazione deve rispettare una gerarchia delle informazioni, avere un linguaggio appropriato e mantenere coerenza dall’inizio alla fine. La qualità si misura anche nel tempo necessario a portarlo alla versione definitiva.
La guida tecnica descrive GPT-6.2 Astra come più conciso e diretto nelle impostazioni predefinite. Invita inoltre a specificare il pubblico a cui è destinato un testo e le convenzioni del progetto. Per chi scrive, questo dettaglio conta quanto una prestazione in classifica. Una relazione per colleghi e un articolo divulgativo richiedono profondità, ritmo e terminologia differenti. La possibilità di orientare queste scelte permette di avvicinare il risultato alla voce editoriale desiderata.
Nel lavoro editoriale, il vantaggio potenziale riguarda soprattutto la continuità. Una stessa pubblicazione può richiedere la verifica dei materiali, la costruzione del discorso e l’adattamento alla pagina. Quando queste fasi rimangono collegate, si riducono le occasioni di ricominciare da capo a ogni passaggio. Per un piccolo editore, un autore indipendente o una redazione, poter trasferire con precisione una scelta di stile dal testo alla presentazione del contenuto sarebbe un miglioramento immediatamente percepibile.
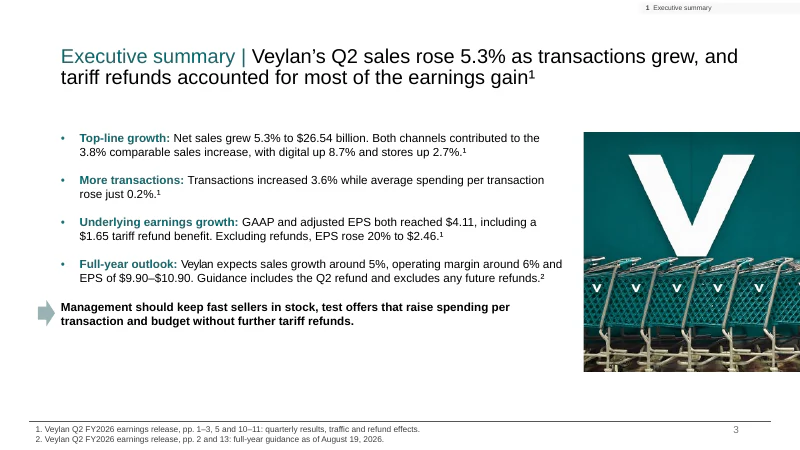
L’esempio della presentazione rende visibile questa esigenza. La slide pubblicata da OpenAI organizza i risultati attorno a una conclusione, a pochi dati di supporto e a un’indicazione operativa. Chi la osserva può giudicare direttamente la distribuzione dello spazio e la leggibilità. Per valutare un assistente grafico, un confronto del genere è utile perché permette di discutere il prodotto concreto, fino alla scelta del titolo e alla quantità di informazioni inserite nella pagina.
Da qui deriva una conseguenza pratica per chi prepara materiali professionali. Un buon riferimento iniziale acquista ancora più valore. Fornire una pagina già approvata, chiarire la funzione del documento e descrivere il lettore desiderato permette di definire un obiettivo osservabile. In una possibile applicazione editoriale, l’AI potrebbe preparare un dossier coerente con una collana esistente, lasciando all’editore la scelta dell’argomento, dell’impostazione e della versione da pubblicare. È uno scenario di lavoro da verificare sui propri materiali.
I benchmark del lavoro completato
Le valutazioni del lavoro professionale cercano proprio di misurare la capacità di portare a termine un incarico. La famiglia di test GDPval è nata per osservare attività economicamente rilevanti in numerose professioni, usando consegne ed elaborati vicini al lavoro reale. Agents’ Last Exam, sviluppato da UC Berkeley RDI, studia flussi professionali con criteri di successo verificabili. Il loro interesse sta nella possibilità di valutare una sequenza di operazioni e il risultato consegnato.
OpenAI riferisce per Astra un vantaggio di 5,2 punti su GPT-6 Astra in Agents’ Last Exam, a meno di un terzo del costo. Su GDPval v2 dichiara un progresso di 6,2 punti percentuali con il 22% di token di output in meno. Questi dati riguardano le configurazioni e i compiti dei test. Offrono un’indicazione del rapporto fra prestazione e consumo, da confrontare poi con il tipo di lavoro che ciascuno svolge davvero.
Il costo di un compito merita attenzione perché racchiude più elementi. Un sistema può avere un prezzo conveniente per ogni unità di testo elaborata e richiedere molti passaggi per arrivare al risultato. Un altro può consumare meno risorse grazie a un percorso più breve. Dal punto di vista di chi commissiona il lavoro, conta anche quante correzioni occorrono dopo la consegna. Il guadagno più interessante emerge quando migliorano insieme il risultato e il processo che lo produce.
Codice da integrare nei progetti reali
La programmazione offre un modo particolarmente concreto per osservare questa differenza. FrontierCode, il benchmark di Cognition, valuta se una modifica sarebbe accettabile per chi mantiene il progetto software. Considera correttezza, qualità dei test e rispetto delle convenzioni del codice esistente. L’idea è vicina a ciò che accade in un gruppo di sviluppo, dove una soluzione deve inserirsi nel progetto e risultare comprensibile a chi continuerà a lavorarci.
Nel confronto pubblicato da OpenAI, con entrambi i modelli al livello di ragionamento Max, Sol arriva a mezzo punto da Astra su FrontierCode 2.0, con circa un quinto del costo. Il dato suggerisce un possibile impiego del modello efficiente anche in attività tecniche consistenti. La scelta può dipendere dalla natura della modifica. Per un intervento circoscritto, una soluzione rapida e ben integrata ha un valore evidente; quando occorre ricostruire molte dipendenze o ripensare una parte del sistema, diventa più interessante il modello dedicato ai progetti complessi.
Per chi sviluppa un prodotto digitale, l’obiettivo pratico è accorciare il percorso fra richiesta e verifica. Una funzione proposta può essere implementata, eseguita e corretta nello stesso ciclo di lavoro. Questo rende più agevole anche discutere un’idea ancora incompleta. Un prototipo funzionante permette di osservare il comportamento del programma e di decidere che cosa cambiare sulla base di un’esperienza concreta. È un tipo di collaborazione che può servire tanto a un professionista quanto a un piccolo gruppo con risorse limitate.
Dalla richiesta alla simulazione tridimensionale
Le schede API chiariscono anche come leggere le capacità visive dei modelli. Astra e Sol ricevono testo e immagini e producono testo; attraverso gli strumenti possono cercare informazioni, eseguire codice e usare il computer. La costruzione di un’esperienza grafica passa quindi dall’interazione con software e ambienti di esecuzione. Questa architettura aiuta a capire come una richiesta espressa in linguaggio naturale possa diventare una scena tridimensionale o un’interfaccia utilizzabile.
Nella dimostrazione automobilistica, OpenAI descrive Astra mentre realizza un modello 3D, scrive in Python la simulazione della dinamica e anima il risultato in Blender. Il caso riunisce competenze che normalmente richiedono passaggi distinti. La geometria deve essere coerente con il comportamento simulato, mentre la visualizzazione deve rendere comprensibile ciò che accade. La schermata pubblicata affianca l’automobile alle sospensioni e ai dati sugli pneumatici, consentendo di osservare più aspetti dello stesso sistema.
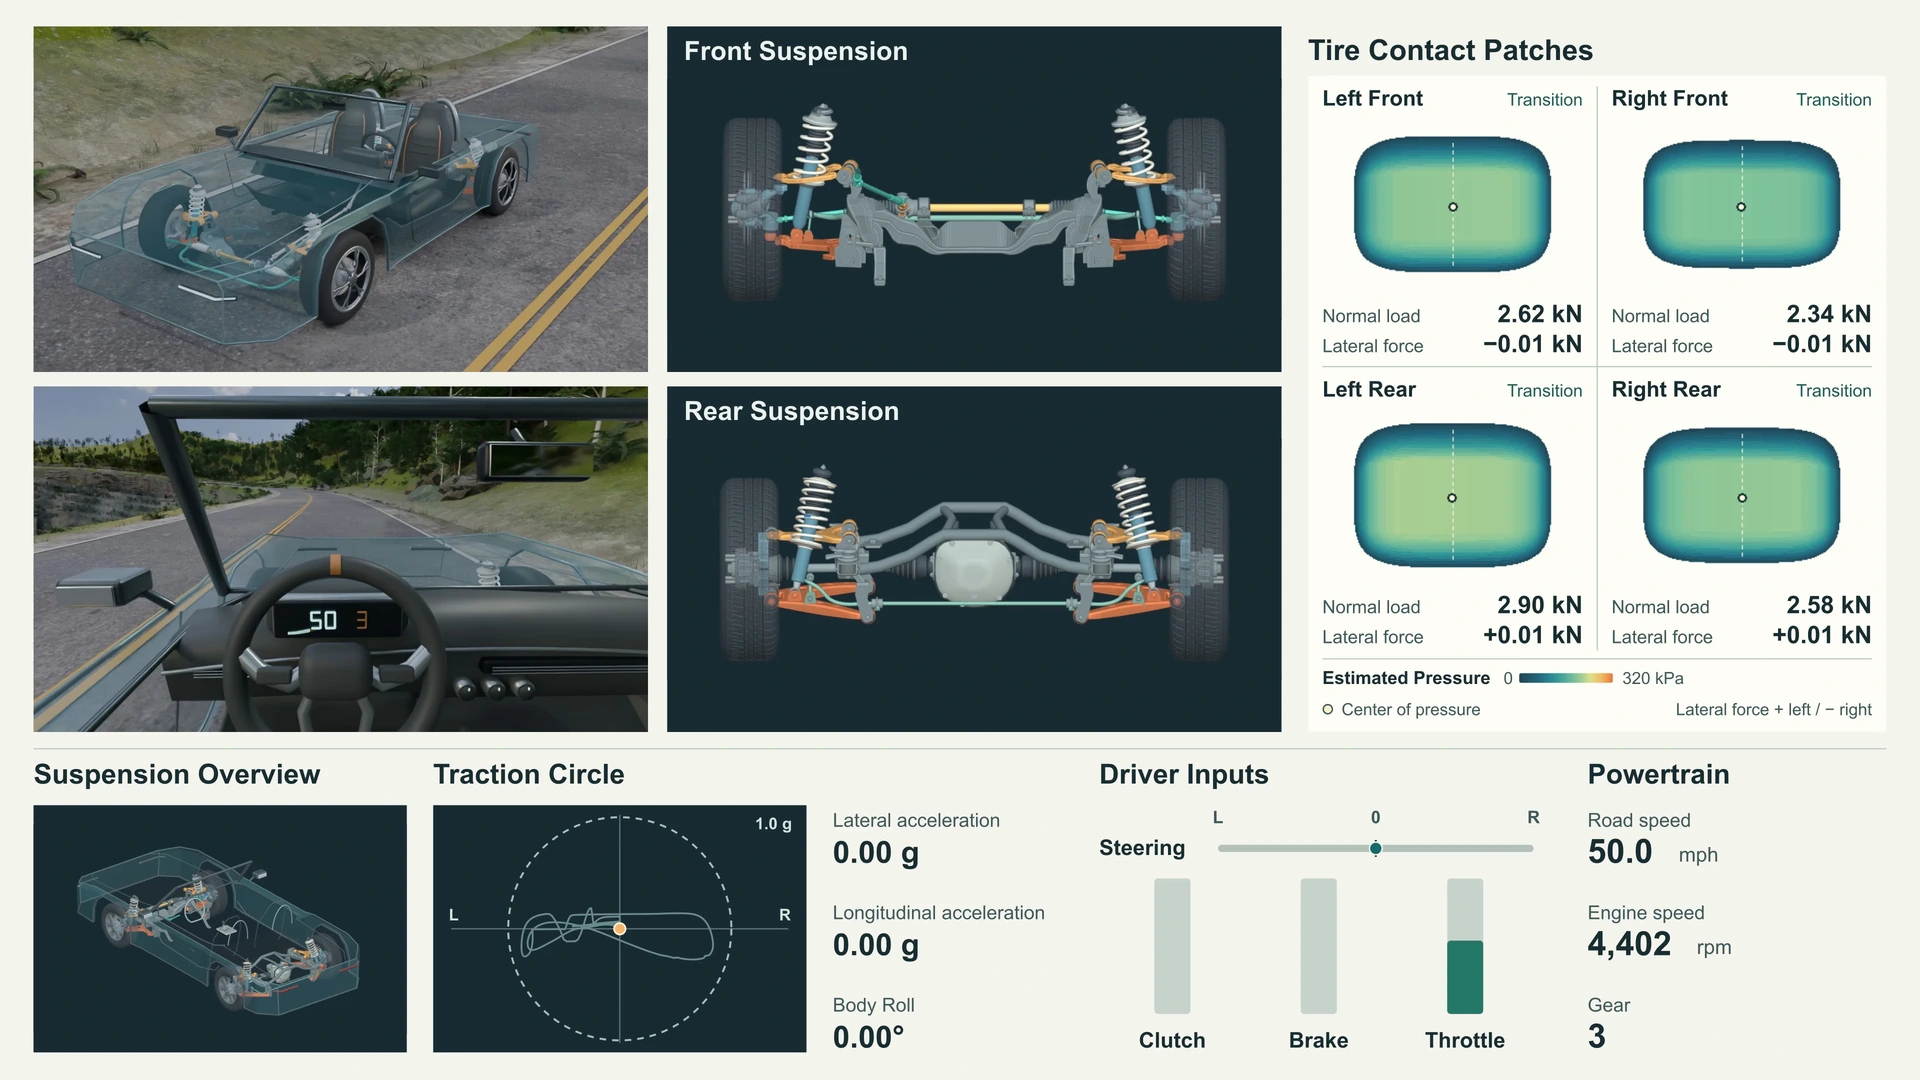
Per la divulgazione tecnica, la possibilità di collegare calcolo e immagine apre prospettive molto concrete. Un contenuto digitale potrebbe affiancare al testo una simulazione nella quale il lettore modifica un parametro e osserva il risultato. Un manuale di grafica potrebbe mostrare come cambia una scena al variare della luce. In questi casi, il valore editoriale dipenderebbe dalla qualità della spiegazione e dalla correttezza del modello scelto, con l’AI impiegata nella costruzione dell’esperienza.
Il confronto sulle esperienze interattive
Su questo terreno esiste anche una valutazione indipendente. AA-3D, realizzato da Artificial Analysis, assegna ai modelli una descrizione scritta e chiede di costruire una scena interattiva con three.js. Le esperienze vengono confrontate da valutatori che esprimono preferenze senza conoscere il modello autore. Nella classifica consultata al lancio, GPT-6.2 Astra raggiunge 1.318 punti Elo, davanti ai 1.271 di Claude Fable 5.2 e ai 1.259 di GPT-6.2 Sol. Il confronto usa le configurazioni Max; per Claude la classifica indica anche il fallback predefinito, che consente il ricorso a un modello di riserva. Sono punteggi relativi alle preferenze raccolte in questo specifico test.
Il risultato è interessante perché mette insieme esecuzione del codice e qualità dell’esperienza visiva. La classifica descrive l’esito delle scene sottoposte ai giudici e va letta entro quel perimetro. Per chi lavora con contenuti interattivi, la verifica decisiva resta il proprio progetto. Conta osservare se l’esperienza risponde alla richiesta, se i controlli risultano comprensibili e se la presentazione aiuta a esplorare il contenuto. Sono criteri utili per trasformare un progresso tecnico in una scelta produttiva.
Il contributo dell’AI alla ricerca scientifica
Anche la ricerca scientifica occupa uno spazio importante nell’annuncio. OpenAI dichiara per Astra un miglioramento di nove punti percentuali su GPT-6 Astra in Terminal-Bench-Science. La descrizione di questo benchmark pubblicata da Artificial Analysis riguarda attività scientifiche eseguite attraverso un terminale, con compiti preparati e controllati da esperti. La valutazione osserva quindi la capacità di portare avanti un lavoro computazionale, nel quale scrivere codice e interpretare i risultati sono parti della stessa attività.
Il rapporto tecnico contiene inoltre un passaggio rilevante per lo sviluppo futuro dell’AI. OpenAI classifica Astra come il primo proprio modello distribuito all’esterno a raggiungere la soglia denominata High nella categoria AI Self-Improvement. La categoria misura la capacità di contribuire alla ricerca che migliora i sistemi AI. Le prove comprendono la diagnosi di esperimenti falliti, l’ottimizzazione di calcoli e attività di addestramento. Sol rimane al di sotto di quella soglia. La valutazione riguarda competenze di ricerca e ingegneria esercitate in condizioni definite.
Il significato industriale è notevole. Se un ricercatore può delegare parte del lavoro necessario a preparare e verificare un esperimento, aumenta lo spazio disponibile per esplorare ipotesi. Se lo stesso strumento aiuta a rendere più efficiente il codice, può ridurre il tempo richiesto dalle prove successive. È una possibile dinamica di accelerazione della ricerca, il cui effetto complessivo dipenderà da come queste capacità saranno integrate nei gruppi di lavoro e nelle infrastrutture disponibili.
Questa prospettiva va tenuta distinta da una dichiarazione sul raggiungimento dell’intelligenza artificiale generale. Il risultato documenta capacità specifiche di assistenza alla ricerca e va interpretato in quei termini. Resta comunque un passaggio interessante. L’AI entra nella produzione degli strumenti con cui si svilupperanno le generazioni successive, creando una relazione sempre più stretta fra uso del modello e avanzamento della tecnologia che lo rende possibile.
Prezzi API e costo effettivo del lavoro
Il tema economico completa il quadro. Nelle API, cioè negli strumenti con cui gli sviluppatori integrano i modelli nelle proprie applicazioni, le tariffe Standard di base di Astra sono di 8 dollari per milione di token in ingresso e 40 dollari per milione in uscita. La lettura dell’input già conservato nella cache costa 0,40 dollari per milione. Rispetto a GPT-6 Astra, ingresso e uscita scendono del 20%, mentre la lettura dalla cache diminuisce del 60%.
Sol mantiene invece i prezzi di GPT-6.1 Sol, con 2 dollari per milione di token in ingresso, 10 dollari in uscita e 0,10 dollari per la lettura dalla cache. A parità di categoria di token, le sue tariffe di base sono un quarto di quelle di Astra. Le cifre si riferiscono al servizio Standard con contesto breve; richieste molto lunghe, scritture nella cache e modalità di elaborazione differenti hanno condizioni dedicate. Gli abbonamenti ChatGPT seguono regole proprie.
Un token è un’unità con cui il sistema elabora il contenuto, spesso corrispondente a una parte di parola. Per chi usa un’applicazione, la quantità di token diventa soprattutto un fattore di costo e capacità operativa. Il prezzo unitario è una parte dell’equazione; l’altra è la quantità necessaria a completare l’attività. Per questo il risparmio osservato in un benchmark e la riduzione di una tariffa descrivono due aspetti differenti, che possono sommarsi quando il modello lavora in modo più efficiente.
Per una piccola impresa digitale, questa combinazione può cambiare la convenienza di un progetto. Un’attività ripetuta su molti documenti amplifica anche una riduzione modesta del costo per singola lavorazione. Diventa quindi interessante valutare servizi che prima richiedevano troppe risorse rispetto al loro valore. Un editore potrebbe considerare nuove forme di consultazione del catalogo; un gruppo di sviluppo potrebbe sperimentare più varianti di una funzione. La sostenibilità economica amplia lo spazio delle idee che vale la pena provare.
Quanto materiale possono considerare i modelli
La documentazione API indica per entrambi una finestra di contesto di 1.050.000 token, con un massimo di 922.000 token in ingresso e 128.000 in uscita. Il contesto è lo spazio entro cui il modello può considerare le informazioni di una richiesta. Per chi lavora su materiali estesi, questo dato interessa perché consente di includere quantità consistenti di testo e istruzioni. I valori descrivono la capacità API; le applicazioni possono adottare configurazioni predefinite differenti.
La disponibilità di molto contesto rende ancora più utile organizzare bene il materiale. Un archivio ampio serve quando è chiaro quali documenti abbiano priorità e quale risultato si voglia ottenere. Nel caso di un libro, per esempio, una guida stilistica coerente può aiutare a mantenere uniformità fra capitoli. La capacità tecnica di ricevere un insieme esteso di contenuti e la qualità delle istruzioni lavorano insieme, dando al progetto una direzione più precisa.
Sol e le attività della vita quotidiana
L’uso quotidiano trova spazio anche nell’evoluzione dei criteri di valutazione. Con LifeVal, presentato all’inizio di novembre, OpenAI ha costruito prove attorno ad attività pratiche che le persone vorrebbero affidare a un assistente. Il lavoro parte da studi sull’impiego del tempo e da un’indagine dedicata alle esigenze degli utenti. Questo orientamento aiuta a comprendere la posizione di Sol, pensato per accompagnare una varietà di richieste ricorrenti e attività articolate in più passaggi.
Il filo comune fra un progetto professionale e una necessità personale è la capacità di rispettare vincoli concreti. Un risultato utile tiene conto del tempo a disposizione e delle preferenze espresse, poi restituisce qualcosa su cui si possa agire. In questa prospettiva, anche un miglioramento meno appariscente può avere molto valore. Dover ripetere meno volte le stesse indicazioni, ricevere un documento più chiaro o trovare una proposta meglio organizzata cambia la qualità dell’esperienza quotidiana.
Disponibilità in Work, Codex e API
Per quanto riguarda l’accesso, la documentazione operativa include i piani Plus, Pro, Business, Enterprise ed Edu per ChatGPT Work, con disponibilità legata ai permessi e all’avanzamento della distribuzione. Negli ambienti Enterprise ed Edu è prevista l’abilitazione da parte degli amministratori. La modalità Chat ordinaria segue una distribuzione distinta; il lancio di Astra e Sol riguarda Work, Codex e API. Chi cerca i nuovi modelli deve quindi considerare anche l’ambiente che sta utilizzando.
Ultrafast: velocità, piani e consumo
Cambia inoltre l’accesso a Ultrafast. Il piano Pro da 200 dollari permette di usare questa modalità con GPT-6.2 Sol in Codex, mentre il piano Pro da 500 dollari la offre con entrambi i modelli. Sono previsti accessi anche per gli ambienti Enterprise ed Edu idonei. La documentazione indica una generazione dei token fino a 4,5 volte più veloce rispetto alla modalità Standard dello stesso modello, con un maggiore consumo della disponibilità d’uso o dei crediti.
La velocità di generazione e la durata di un incarico restano misure differenti. Un progetto comprende anche l’apertura dei file, l’esecuzione dei programmi e la verifica dei risultati. L’accelerazione diventa particolarmente interessante quando riduce l’attesa nei passaggi in cui si collabora direttamente con il modello. Per un lavoro lungo affidato all’agente, possono invece pesare di più la qualità del percorso e la quantità di risorse impiegate. Anche qui, la scelta più utile dipende dall’attività.
Valutare l’AI sulla qualità delle consegne
Il lancio di GPT-6.2 suggerisce così una lettura del progresso dell’AI centrata sul lavoro completato. Le classifiche aiutano a osservare le capacità; i documenti, il codice e le esperienze interattive mostrano come quelle capacità possono essere impiegate. Per chi crea contenuti o sviluppa prodotti, il punto da verificare è quanto si accorci il percorso fra un’intenzione e una versione pronta da usare. È su quel percorso che un aggiornamento tecnologico può tradursi in tempo recuperato e nuove possibilità produttive.
Astra e Sol propongono due modi complementari di affrontare questo lavoro. La loro utilità emergerà nei progetti in cui verranno inseriti, nelle revisioni che riusciranno a semplificare e nella qualità delle consegne. Per l’editoria digitale, la progettazione e lo sviluppo software, la prospettiva più interessante è poter dedicare una quota crescente dell’impegno alla scelta delle idee e alla definizione del risultato, con strumenti capaci di accompagnarne la realizzazione fino a una forma concreta.
Fonti
- OpenAI, Introducing GPT-6.2 Astra and Sol. Annuncio del lancio, risultati dichiarati, dimostrazioni e immagini ufficiali.
- ChatGPT Learn, GPT-6.2. Disponibilità, ambienti di utilizzo e indicazioni sulla scelta dei modelli.
- OpenAI Help Center, ChatGPT Work and Codex. Distribuzione, distinzione dalla Chat ordinaria e accesso a Ultrafast.
- OpenAI API, GPT-6.2 Astra. Specifiche tecniche, contesto, modalità supportate e tariffe.
- OpenAI API, GPT-6.2 Sol. Specifiche tecniche, strumenti e tariffe.
- OpenAI API, Pricing. Confronto dei prezzi con i modelli precedenti e condizioni dei servizi.
- OpenAI API, Using GPT-6.2. Comportamento dei modelli e indicazioni per scrittura, sviluppo e integrazione.
- ChatGPT Learn, Fast and Ultrafast modes. Velocità di generazione, consumo e requisiti di accesso.
- OpenAI, Measuring the performance of our models on real-world tasks. Origine e impostazione della famiglia di valutazioni GDPval.
- UC Berkeley RDI, Agents’ Last Exam. Valutazione degli agenti su attività professionali con criteri verificabili.
- Cognition, FrontierCode. Metodologia di valutazione delle modifiche a progetti software.
- Artificial Analysis, AA-3D. Metodologia e classifica delle esperienze tridimensionali interattive.
- Artificial Analysis, Intelligence Index v5. Descrizione di Terminal-Bench-Science e delle valutazioni incluse nell’indice.
- OpenAI, GPT-6.2 System Card. Valutazioni delle capacità, con particolare riferimento all’assistenza alla ricerca sull’AI.
- OpenAI, LifeVal. Valutazione delle attività pratiche della vita quotidiana.
Copertina. La grafica del lancio di GPT-6.2 Astra e Sol. Fonte e immagine: OpenAI.