Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna spostano la competizione verso efficienza, velocità e sostenibilità economica dei carichi di lavoro.
La competizione tra i principali laboratori di intelligenza artificiale entra in una fase sempre più legata al rapporto tra prestazioni e prezzo. Anthropic ha presentato Claude Opus 5.5, mentre OpenAI ha introdotto GPT-6 Sol e GPT-6 Luna come livelli più efficienti della propria offerta. Le capacità dei modelli restano essenziali, insieme a un tema ormai decisivo per aziende e sviluppatori: quanto costa trasformare una dimostrazione interessante in un servizio utilizzato ogni giorno.
Il cambiamento riguarda soprattutto chi accede ai modelli attraverso le API, le interfacce che consentono a software e piattaforme di inviare richieste e ricevere risultati. Una differenza apparentemente ridotta nel costo unitario può incidere molto quando le operazioni diventano migliaia o milioni. Elaborazione di documenti, assistenti integrati nei prodotti e automazioni editoriali acquistano così una sostenibilità economica diversa rispetto a quella dei primi servizi costruiti sui modelli di fascia più alta.
Anthropic dichiara che Claude Opus 5.5 riduce di circa il 40% il costo dei carichi di lavoro tipici rispetto a Opus 5. Il listino ufficiale indica 4 dollari per un milione di token in input e 20 dollari per un milione di token in output. L’azienda associa al nuovo modello anche una velocità di generazione superiore di oltre il 30% e un prezzo di 0,20 dollari per un milione di token letti dalla cache.
I token sono le unità in cui un modello suddivide il testo durante l’elaborazione. Quelli in input comprendono le istruzioni e i contenuti inviati al sistema; quelli in output corrispondono alla risposta generata. La distinzione ha conseguenze concrete: analizzare grandi quantità di materiale e produrre testi molto lunghi possono avere profili di costo differenti. Il caching consente invece di riutilizzare parti già elaborate, come istruzioni ricorrenti o documenti di riferimento, evitando di pagare ogni volta l’intero processo allo stesso prezzo.
OpenAI propone una struttura più articolata. GPT-6 Sol ha un prezzo API standard di 2 dollari per un milione di token in input e 10 dollari per un milione in output. GPT-6 Luna scende a 0,10 dollari per l’input e 0,50 dollari per l’output. Entrambi sono disponibili anche attraverso livelli Fast, mentre GPT-6 Astra mantiene il ruolo di modello più potente e costoso della famiglia. Sol e Luna sono quindi orientati verso carichi quotidiani o ad alto volume, nei quali l’efficienza pesa quanto la prestazione massima.
Un confronto diretto basato esclusivamente sui prezzi rischia di produrre conclusioni poco utili. Ogni modello offre una diversa combinazione di capacità, velocità, lunghezza del contesto e affidabilità sul singolo compito. Anche i benchmark pubblicati dai produttori seguono perimetri e metodologie che non coincidono sempre. I listini permettono di individuare le fasce economiche; la scelta operativa richiede prove condotte sui documenti, sulle richieste e sui formati realmente utilizzati dall’organizzazione.
La riduzione dei prezzi favorisce architetture nelle quali più modelli collaborano all’interno dello stesso flusso. Un router può affidare le richieste ordinarie a un’opzione economica e riservare il modello più avanzato ai casi complessi. Lo stesso principio viene applicato agli strumenti di orchestrazione che combinano servizi proprietari e modelli open-weight, i cui pesi possono essere gestiti su infrastrutture scelte dall’utilizzatore nel rispetto delle relative licenze. Il valore si sposta gradualmente dalla selezione di un unico modello alla capacità di assegnare ogni attività alla risorsa adeguata.
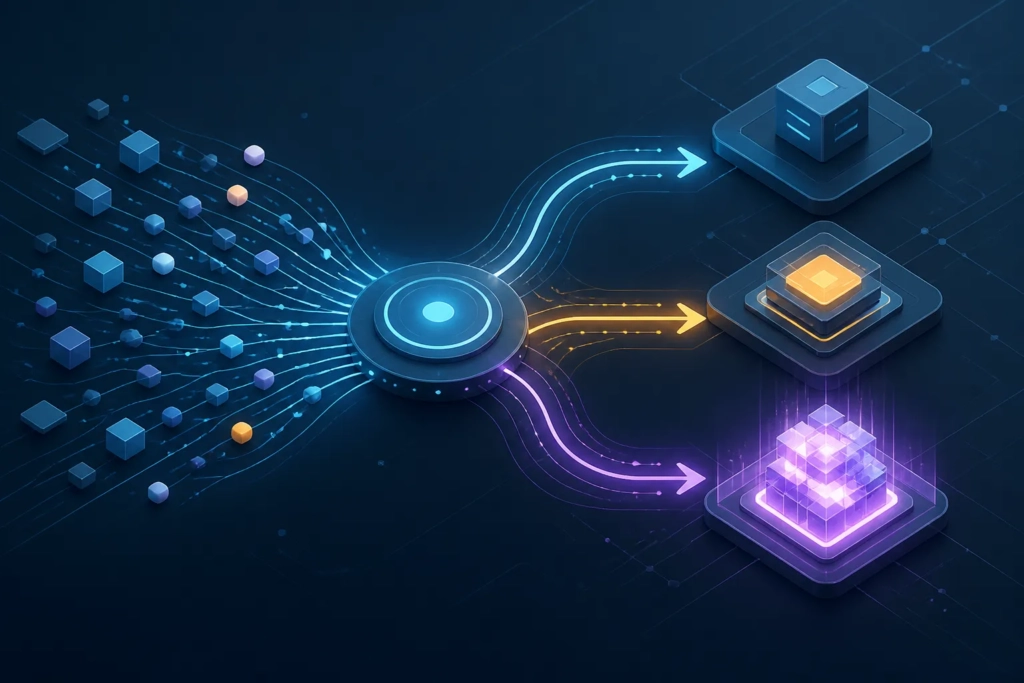
Velocità e caching contribuiscono a questa evoluzione quanto il prezzo per token. Una risposta più rapida migliora l’esperienza nei servizi interattivi e permette di completare più operazioni nella stessa finestra di tempo. La cache diventa particolarmente utile quando molte richieste condividono un insieme stabile di istruzioni, regole o materiali. I risparmi effettivi dipendono dalla struttura del carico di lavoro e dalla frequenza con cui le informazioni possono essere riutilizzate.
Per editori, redazioni e professionisti dei contenuti, modelli meno costosi ampliano lo spazio per attività ripetitive ad alto volume. La classificazione di archivi, la preparazione di metadati e la sintesi preliminare di documenti possono essere integrate in processi continuativi. La revisione editoriale mantiene un ruolo essenziale nelle fasi che richiedono accuratezza, coerenza stilistica e responsabilità sul contenuto pubblicato. Il vantaggio economico emerge soprattutto quando l’automazione libera tempo senza abbassare la qualità finale.
Anche le piccole e medie imprese possono adottare una strategia più selettiva. Le richieste semplici possono essere gestite da un modello economico, mentre analisi articolate o documenti delicati vengono inviati a un livello superiore. Questo approccio consente di sperimentare servizi interni, estrazione di dati e produzione di report con budget più prevedibili. Un portafoglio stratificato riduce inoltre la dipendenza economica dal modello più costoso per ogni singola operazione.
Il prezzo dichiarato dalle aziende costituisce una parte del costo complessivo. Una valutazione accurata deve misurare il tasso di completamento, il numero di tentativi necessari e la latenza. Vanno poi conteggiati l’integrazione tecnica, il monitoraggio e la revisione umana. Un modello molto economico può richiedere più passaggi per raggiungere il risultato desiderato; un’opzione più costosa può risultare conveniente quando risolve il compito al primo tentativo. La metrica più utile diventa quindi il costo per attività completata, non il semplice costo per milione di token.
Un percorso operativo può partire dalla suddivisione delle attività per complessità e volume. La fase successiva consiste nell’assegnare a ogni categoria il modello meno costoso capace di rispettare gli standard richiesti. I modelli di fascia alta possono essere riservati alle eccezioni, alle richieste lunghe e ai passaggi che richiedono maggiore precisione. Test periodici su campioni reali aiutano a correggere l’assegnazione quando cambiano i listini o arrivano versioni più efficienti.
I nuovi modelli di Anthropic e OpenAI mostrano quanto l’economia dell’intelligenza artificiale stia diventando importante quanto l’avanzamento delle capacità. Prezzi inferiori, maggiore velocità e offerte distribuite su più livelli rendono più accessibile l’uso continuativo delle API. Per chi costruisce prodotti e workflow, la scelta vincente dipenderà sempre più dalla progettazione dell’intero sistema: modello adeguato, instradamento intelligente, caching efficace e misurazione del costo reale di ogni risultato.
Fonti
- Ars Technica – New Anthropic, OpenAI models make same promise: A little more for a lot less money
- Anthropic – Introducing Claude Opus 5.5
- OpenAI API Pricing