Una risposta attendibile nasce anche dalle regole che rendono una fonte utilizzabile: identità, autorità, validità temporale e accesso. Come costruire e mantenere il corpus che alimenta l’AI in una redazione.
Immaginiamo una redazione che utilizzi l’intelligenza artificiale per preparare le schede dei libri. Nei suoi sistemi convivono il catalogo aggiornato, le presentazioni commerciali delle stagioni precedenti, i comunicati di lancio e le bozze delle nuove edizioni. Alla richiesta di descrivere un volume, l’assistente recupera un testo completo, scorrevole e ricco di dettagli. Quel testo, però, riguarda un’edizione fuori catalogo. La risposta può apparire convincente e contenere insieme informazioni corrette, dati superati e caratteristiche appartenenti a un altro prodotto.
La difficoltà nasce dal rapporto tra documenti molto simili, ciascuno valido in un determinato contesto. Per una persona esperta, una data, una cartella o il ricordo di una riunione possono bastare a riconoscere la versione giusta. Un sistema di recupero deve trovare queste distinzioni in una forma esplicita, leggibile e applicabile durante la ricerca.
Progettare una base di conoscenza significa rendere operative tali distinzioni. L’archivio conserva la memoria dell’organizzazione; il corpus destinato all’AI stabilisce quali parti di quella memoria possano sostenere una risposta, per quale attività e a quali condizioni. È una scelta infrastrutturale con conseguenze editoriali immediate: determina quali affermazioni il sistema potrà proporre come attendibili.
Partire dal compito per definire le fonti
La prima decisione riguarda il lavoro che l’assistente deve svolgere. Preparare una scheda commerciale, ricostruire la storia di una collana e aiutare un redattore a orientarsi tra i materiali di lavorazione richiedono raccolte differenti. Nel primo caso prevalgono i dati correnti approvati per la diffusione. Nel secondo acquistano valore anche documenti storici. Nel terzo possono servire materiali provvisori, purché il loro stato resti visibile.
Questa distinzione permette di separare il patrimonio conservato dal materiale effettivamente abilitato al recupero. Un comunicato di dieci anni fa può essere una fonte eccellente per studiare il posizionamento originario di un libro. La stessa fonte diventa inadatta a stabilirne il prezzo attuale. L’affidabilità appartiene quindi alla relazione tra documento, domanda e momento di utilizzo. Trattarla come una qualità assoluta del file produce equivoci difficili da riconoscere nella risposta finale.
Una redazione può partire da un’attività circoscritta, per esempio la preparazione delle schede delle edizioni disponibili, e individuare le raccolte necessarie a sostenerla. Il catalogo fornisce i dati bibliografici e commerciali; una raccolta di descrizioni approvate offre il testo utilizzabile; un registro delle condizioni di diffusione chiarisce eventuali vincoli. Ogni sorgente entra con una funzione precisa, evitando che l’accumulo di materiali diventi il criterio principale di costruzione del sistema.
Anche l’esclusione assume così un significato editoriale. Una cartella di appunti può restare accessibile agli esseri umani e fuori dal recupero automatico destinato alla comunicazione pubblica. La sua conservazione risponde a un’esigenza di memoria; l’inclusione nel corpus richiede una valutazione ulteriore sulla qualità, sull’utilità e sulle condizioni di impiego.
La somiglianza tra testi e l’autorità delle fonti
Per comprendere queste scelte basta osservare il funzionamento generale del recupero. Nei sistemi comunemente indicati come RAG, la ricerca seleziona contenuti da fornire al modello insieme alla richiesta dell’utente. Il modello usa quel contesto per formulare la risposta. La documentazione OpenAI sul retrieval descrive, tra le possibilità, la ricerca semantica su dati propri attraverso indici vettoriali: rappresentazioni numeriche che aiutano a trovare passaggi vicini al significato della domanda.
Questa capacità è utile quando il lessico della richiesta differisce da quello dei documenti. Una domanda sui libri adatti a lettori principianti può trovare una descrizione che parla di introduzione alla materia. La vicinanza semantica, tuttavia, non certifica l’autorità della fonte. Un vecchio testo promozionale, ricco di spiegazioni, può risultare più vicino alla domanda di una scheda tecnica aggiornata e molto sintetica.
Per rendere affidabile il recupero occorre affiancare alla pertinenza altre condizioni. Lo stato di approvazione, l’edizione interessata, la destinazione del contenuto e la sua validità temporale devono contribuire a delimitare i candidati. Filtri, partizioni delle raccolte e regole di selezione possono operare prima che il materiale raggiunga il modello. La configurazione concreta dipende dagli strumenti adottati; il principio organizzativo resta stabile: una fonte entra nel contesto perché è pertinente e ammissibile per quella richiesta.
Caricare documenti attraverso un sistema di retrieval, inoltre, è un’operazione distinta dall’addestramento del modello. Il materiale recuperato costituisce un contesto di lavoro. La presenza di una base interna, da sola, lascia aperta la possibilità che la risposta mescoli quel contesto con conoscenze generali o inferenze. Per attività strettamente documentali serve quindi una regola esplicita che vincoli le affermazioni alle informazioni effettivamente disponibili.
Assegnare autorità a informazioni precise
La gerarchia delle fonti funziona meglio quando riguarda singoli ambiti informativi. Definire un documento come ufficiale può essere insufficiente: una presentazione commerciale approvata potrebbe descrivere correttamente il contenuto di un libro e riportare un prezzo ormai superato. La fonte canonica è quella riconosciuta dall’organizzazione come riferimento per un certo dato, entro un perimetro dichiarato.
Nel nostro esempio, il gestionale di catalogo può fare autorità su formato e disponibilità; il testo approvato dalla redazione può essere il riferimento per la descrizione; l’ufficio competente può stabilire quando una copertina diventa pubblicabile. Questa distribuzione evita di attribuire a un unico file competenze che appartengono a processi diversi. Permette anche di aggiornare un’informazione senza riapprovare ogni documento che la contiene.
La data più recente offre un indizio, da interpretare insieme allo stato del materiale. Una bozza modificata ieri può avere meno autorità di una versione approvata la settimana precedente. Analogamente, una deroga valida per una campagna specifica dovrebbe restare legata a quella campagna. Trasformarla in una regola generale allargherebbe il suo significato oltre la decisione originaria.
Quando due fonti abilitate si contraddicono, il sistema deve poter riconoscere il conflitto e applicare una precedenza definita, oppure richiedere una verifica. La scelta di quale informazione prevalga appartiene a chi ne ha la responsabilità. Il recupero può rendere visibile l’incongruenza; risolverla richiede un’autorità organizzativa identificabile. Anche una segnalazione di conflitto costituisce un esito utile, perché impedisce che l’ambiguità venga assorbita in una frase apparentemente certa.
Conservare l’identità delle informazioni durante l’indicizzazione
Per alimentare la ricerca, molti sistemi dividono i documenti in frammenti. Questa operazione rende gestibili testi lunghi e consente di recuperare passaggi specifici. Introduce però un problema: il significato locale di un paragrafo può dipendere da informazioni collocate altrove, come il titolo del documento, l’intestazione di una tabella o una nota sulla validità.
Nel catalogo editoriale la distinzione tra opera ed edizione è particolarmente importante. Due libri possono condividere autore e titolo e differire per traduzione, formato, apparati, destinatari e disponibilità. Un frammento che conserva soltanto il titolo rischia di perdere l’identità dell’oggetto descritto. Un identificativo interno stabile e, dove pertinente, l’ISBN aiutano a collegare il contenuto all’edizione corretta.
I metadati devono accompagnare il materiale fino al recupero. Stato di approvazione, versione, ambito, lingua, responsabile, condizioni di accesso e periodo di validità sono utili quando il sistema può usarli per selezionare o interpretare i passaggi. La sola presenza di questi dati in un nome di cartella serve poco se l’indicizzazione li scarta. La progettazione deve quindi verificare ciò che arriva realmente nel contesto del modello.
Lo stesso vale per la struttura dei documenti. Una tabella estratta senza intestazioni può associare numeri e significati in modo ambiguo; una nota staccata dalla frase a cui si riferisce può perdere la propria funzione. La qualità del corpus comprende la qualità della sua trasformazione tecnica. Conviene esaminare alcuni frammenti effettivamente recuperati, osservando se mantengono identità, relazioni e condizioni di validità sufficienti a sostenere una risposta.
L’aggiornamento deve raggiungere tutte le copie operative
Correggere il documento originale avvia l’aggiornamento della base di conoscenza. A seconda dell’architettura, possono seguire estrazione del testo, suddivisione in frammenti, indicizzazione e aggiornamento di copie temporanee. Tra la modifica alla sorgente e la disponibilità della nuova informazione può trascorrere un intervallo. Durante quel periodo, l’assistente potrebbe continuare a recuperare contenuti precedenti.
La documentazione AWS sulle knowledge base tratta esplicitamente sincronizzazione e ingestione come componenti del sistema. Per una redazione, questo significa tradurre l’idea generica di aggiornamento in un comportamento verificabile: sapere quando la sorgente è cambiata, quando l’indice ha recepito la modifica e quale versione viene utilizzata nella risposta. La frequenza adatta dipende dall’informazione. Una descrizione di collana può restare stabile a lungo; la disponibilità commerciale può richiedere un collegamento più diretto con il sistema che la gestisce.
Merita particolare attenzione la revoca. Un contenuto ritirato, un’informazione errata o un permesso modificato richiedono che la variazione raggiunga anche i frammenti indicizzati e le eventuali copie riutilizzate dal servizio. La procedura dovrebbe rendere riconoscibile il completamento di questo passaggio. In caso contrario, il documento può risultare corretto nell’archivio e continuare a produrre effetti nella ricerca.
Per mantenere tracciabilità, ogni risposta documentale dovrebbe poter essere ricondotta alla versione effettivamente usata. Un collegamento che conduce sempre all’ultima versione può essere utile alla consultazione corrente, mentre la ricostruzione di una risposta passata richiede un riferimento stabile. Conservare questa distinzione aiuta a capire se un errore dipendesse dalla fonte allora disponibile, dalla selezione dei passaggi o dalla formulazione generata.
I permessi delimitano ciò che può essere recuperato
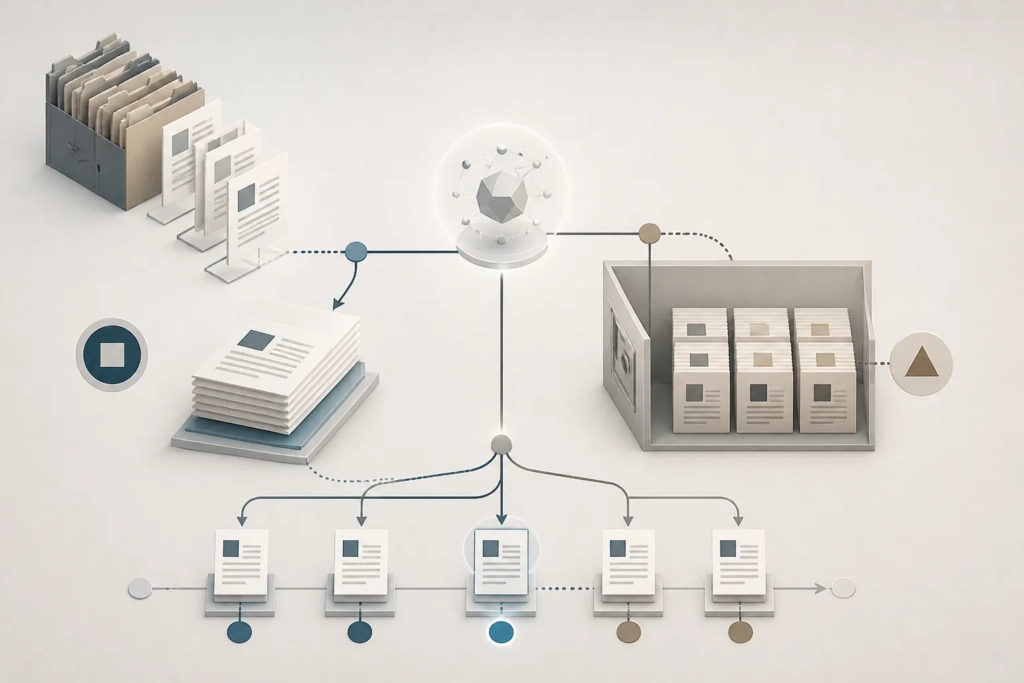
Una base interna può contenere materiali con livelli di riservatezza molto diversi. In una casa editrice convivono informazioni pubbliche, manoscritti inediti, dati personali, condizioni contrattuali e dettagli commerciali. L’utilità di una fonte per una domanda va valutata insieme al diritto dell’utente di accedervi e alla destinazione prevista per il risultato.
Il controllo degli accessi dovrebbe intervenire prima che i contenuti riservati raggiungano il modello. Affidare alla sola istruzione testuale il compito di nascondere informazioni già recuperate offre una barriera insufficiente. Servono filtri coerenti con l’identità dell’utente e con i permessi effettivi, anche quando la ricerca attraversa più raccolte. Le modalità dipendono dall’infrastruttura, ma il requisito riguarda l’intero percorso del dato.
Resta poi una distinzione tra consultazione e riuso. Un redattore può essere autorizzato a leggere un accordo e avere bisogno di ricavarne un’indicazione per il proprio lavoro. La preparazione di una scheda pubblica richiede invece che entrino nel testo soltanto informazioni ammesse alla diffusione. Separare questi contesti riduce il rischio che dettagli interni confluiscano in una comunicazione esterna attraverso una sintesi troppo ampia.
Anche le istruzioni contenute nei documenti devono conservare lo statuto di materiale da esaminare. Un allegato o un testo importato può includere frasi che chiedono al sistema di cambiare comportamento. L’architettura deve mantenere distinta l’autorità delle regole operative dal contenuto delle fonti. La provenienza interna, da sola, non rende ogni frase una direttiva valida per l’assistente.
Una citazione deve sostenere l’affermazione a cui si riferisce
La presenza di un riferimento alla fonte migliora la verificabilità della risposta, a condizione che il collegamento sia preciso. Un documento può parlare dello stesso libro senza sostenere una specifica affermazione sul prezzo, sulla traduzione o sui diritti disponibili. La citazione deve permettere al lettore di riconoscere il passaggio pertinente e comprenderne l’ambito.
Una risposta composta da informazioni provenienti da sorgenti diverse richiede particolare cura. Nel nostro esempio, la descrizione del contenuto e il dato sulla disponibilità potrebbero avere origini differenti. Renderle riconoscibili aiuta il redattore a verificare ciascuna parte e a individuare il responsabile di un’eventuale correzione. La tracciabilità acquista così una funzione concreta nel lavoro quotidiano.
Le lacune devono restare visibili. Se il corpus contiene la descrizione approvata della nuova edizione e soltanto il prezzo di quella precedente, il sistema può preparare la parte descrittiva e segnalare il dato da confermare. Estendere il prezzo storico alla nuova scheda introdurrebbe un’inferenza priva di supporto. Un risultato parziale, con confini espliciti, può essere più utile di una scheda completa la cui affidabilità varia da frase a frase.
Per valutare il sistema conviene quindi osservare il percorso tra richiesta, materiali recuperati e risposta. Se manca il documento corretto, la causa può trovarsi nella selezione del corpus, nei metadati o nell’indice. Se il passaggio è presente e viene interpretato male, occorre intervenire su un’altra parte del processo. Questa lettura evita di attribuire ogni errore al modello e rende più mirata la correzione.
La manutenzione richiede responsabilità sostenibili
Un corpus affidabile ha bisogno di persone che possano approvare una fonte, chiarirne l’ambito, correggerla e ritirarla. Queste responsabilità possono essere distribuite tra redazione, commerciale, amministrazione e area tecnica. L’importante è che ogni raccolta abbia un referente riconoscibile e che le modifiche rilevanti attraversino un percorso comprensibile.
La cornice del NIST AI Risk Management Framework colloca governance e gestione del rischio lungo il ciclo di vita dei sistemi. Applicata a una base editoriale, questa impostazione invita a considerare la manutenzione come parte ordinaria del servizio. Le scelte concrete sul corpus restano responsabilità dell’organizzazione: le fonti tecniche descrivono strumenti e principi generali, mentre l’autorità sui contenuti dipende dai processi effettivi della casa editrice.
La sostenibilità suggerisce di limitare inizialmente il perimetro. Una raccolta circoscritta, legata a un’attività frequente e con responsabili disponibili, permette di rendere espliciti i costi di aggiornamento. Estendere il sistema a nuovi materiali significa assumere anche il loro mantenimento: classificare eccezioni, gestire permessi, verificare estrazioni e risolvere contraddizioni. La quantità di file caricati misura poco questa capacità.
Il lavoro produce valore quando una correzione torna alla sorgente appropriata. Se un redattore scopre una descrizione superata, la soluzione duratura consiste nell’aggiornare il riferimento e far propagare la modifica. Correggere soltanto la risposta lascia intatta la causa. Un canale semplice di segnalazione, collegato ai responsabili delle fonti, trasforma l’uso quotidiano dell’assistente in un’occasione di manutenzione del patrimonio informativo.
Un risultato utile conserva i propri confini
La scheda del libro da cui siamo partiti può diventare un buon esempio di progettazione riuscita. Il sistema riconosce l’edizione richiesta, recupera la descrizione approvata, usa i dati commerciali autorizzati e lascia in sospeso ciò che richiede conferma. Chi la riceve vede quali informazioni sono pronte per l’impiego e quali necessitano di un passaggio ulteriore. Il vantaggio consiste nella possibilità di lavorare su una base riconoscibile, evitando di ricostruire ogni volta la provenienza dei dati.
Questa capacità dipende da decisioni prese prima della generazione: quali fonti ammettere, quale autorità assegnare loro, come conservarne l’identità e quando interromperne l’uso. Il corpus diventa così un servizio editoriale con confini dichiarati e responsabilità precise. La sua qualità si misura nella corrispondenza tra ciò che l’organizzazione può documentare e ciò che l’assistente è autorizzato ad affermare.