
La sfida sull’intelligenza artificiale generativa oggi ruota intorno a due attori principali: OpenAI e Google. Tutto il resto del settore, dai concorrenti diretti come Anthropic e xAI fino all’ecosistema open source, si muove in un campo che viene ridefinito in modo costante da ciò che queste due aziende rendono possibile con le loro famiglie di modelli, GPT da una parte e Gemini dall’altra. Questa centralità nasce soprattutto dalla capacità di trasformare i modelli in infrastruttura per prodotti, servizi e flussi di lavoro che milioni di persone utilizzano ogni giorno, più che dai risultati di benchmark.
Lungo l’arco che va dal lancio di Bard nel 2023 fino all’attuale fase di GPT-5, della variante GPT-5 Pro e della famiglia Gemini 3.0, che comprende modelli più snelli come Gemini 3 Flash e il modello di punta Gemini 3 Pro affiancati dai generatori di immagini Nano Banana e Nano Banana Pro, la competizione si gioca su tre piani: potenza tecnica dei modelli, integrazione nei prodotti di massa, capacità di estendere i modelli testuali verso immagini e video e di supportare applicazioni agentiche sempre più autonome. L’obiettivo finale resta invariato: diventare la piattaforma di riferimento su cui persone, aziende e sviluppatori costruiscono il proprio lavoro quotidiano, riducendo l’attrito tra l’idea e la sua realizzazione.
In questa analisi entriamo nel dettaglio dell’evoluzione dei modelli linguistici, dei generatori di immagini e video, delle prestazioni sui benchmark e della diffusione reale presso gli utenti.
Due strategie a confronto: GPT contro Gemini
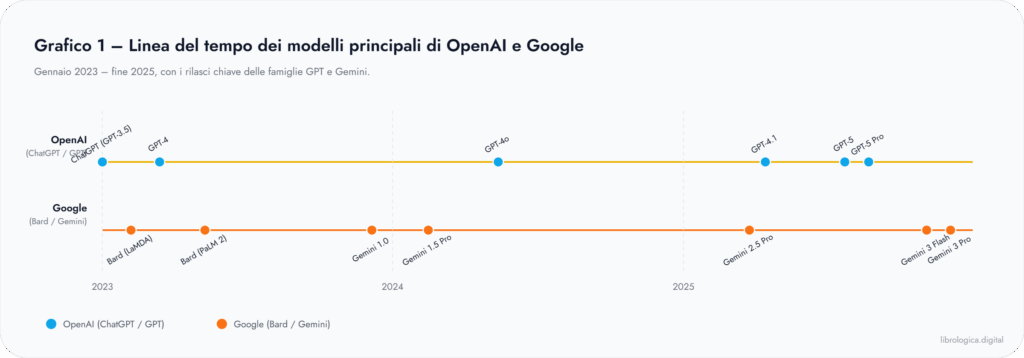
Dal punto di vista storico, Google è entrata pubblicamente in campo con Bard nel febbraio 2023, inizialmente basato su LaMDA e poi su PaLM 2. Bard è nato in risposta diretta al successo di ChatGPT, che aveva raggiunto circa 100 milioni di utenti mensili già a gennaio 2023, due mesi dopo il lancio. Il debutto di Bard ha aperto una fase in cui Google porta all’esterno anni di ricerca sull’elaborazione del linguaggio e tenta di integrare l’AI conversazionale nel proprio motore di ricerca e nei servizi consumer.
Nel 2024 Bard è evoluto nel brand Gemini, con una famiglia di modelli che punta molto sulla capacità di gestire contesti lunghissimi e input multimodali. Gemini 1.0 ha introdotto l’idea di un modello nativamente multimodale, Gemini 1.5 Pro ha aperto ai developer una finestra di contesto fino a 2 milioni di token, confermata nel blog ufficiale di Google come una delle più estese disponibili per un modello di produzione al momento del lancio. Gemini 2.0 e 2.5 hanno consolidato questa linea: versioni pensate per la produzione, per l’uso in Workspace, per la ricerca e per gli strumenti destinati agli sviluppatori rafforzano la percezione di un ecosistema ampio e coordinato.
OpenAI ha seguito una traiettoria diversa. Dopo GPT-3.5 e il successo di ChatGPT, a marzo 2023 è arrivato GPT-4, che è diventato la base per Bing Chat e per Copilot in Microsoft 365, oltre che per la versione a pagamento di ChatGPT. GPT-4 ha introdotto un salto significativo nel ragionamento, nella scrittura strutturata e nella capacità di seguire istruzioni complesse. Nel maggio 2024 viene presentato GPT-4o, modello multimodale “omni” che gestisce testo, immagini e audio in modo nativo con una finestra di contesto di 128k token. GPT-4o è entrato rapidamente nell’interfaccia di ChatGPT ed è diventato il modello predefinito per gli utenti gratuiti, allargando la platea di persone che hanno accesso a funzionalità avanzate.
Il 2025 ha visto un ulteriore salto. Da un lato OpenAI ha introdotto GPT-4.1, con contesto fino a 1 milione di token per gli sviluppatori e miglioramenti sensibili nel coding e nella gestione di progetti complessi. Successivamente è arrivato GPT-5 con risultati record su matematica e programmazione reale e, in seguito, la variante GPT-5 Pro per scenari agentici e carichi di lavoro più intensivi, pensata per orchestrare flussi di lavoro lunghi, multi-step e coordinati con strumenti esterni. Dall’altro Google ha completato la stagione di Gemini 2.5 Pro e, a fine anno, ha lanciato la famiglia Gemini 3.0: Gemini 3 Pro come modello di punta per il ragionamento e Gemini 3 Flash come versione più snella, progettata per risposte rapide, costi inferiori e alta scalabilità, entrambe con finestre di contesto nell’ordine del milione di token e con una migliore efficienza del thinking.
Gemini 3.0 ha introdotto anche un affinamento nella distinzione dei livelli di reasoning: l’utente o lo sviluppatore può controllare il grado di “pensiero” assegnato a ogni richiesta, bilanciando tempo di risposta e profondità. In parallelo, OpenAI sperimenta setup analoghi con modalità di reasoning più estese in GPT-5 Pro, in cui la catena di pensiero interna viene espansa quando il modello individua problemi complessi di coding, matematica o pianificazione.
Per visualizzare questa traiettoria parallela conviene introdurre un primo grafico.
Contesto, architettura e ragionamento
La sfida tecnica oggi si concentra soprattutto sulla capacità di gestire grandi quantità di contesto e di trasformarle in ragionamento utile, stabile e controllabile. Il contesto lungo permette di caricare interi manuali, corpus di documenti, repository di codice, trascrizioni di riunioni e flussi video, mantenendo una comprensione coerente nel corso della conversazione.
Google con Gemini 1.5 Pro è stata la prima a comunicare pubblicamente un contesto di 2 milioni di token, accessibile in produzione tramite l’API per tutti gli sviluppatori, andando oltre i limiti dei 32k o 128k a cui ci si era abituati con altri modelli. L’obiettivo dichiarato è permettere all’intelligenza artificiale di lavorare su interi progetti: repository di codice completi, basi documentali estese, set di trascrizioni audio e video. Con Gemini 2.5 Pro questo approccio si è consolidato, mentre con Gemini 3 Pro questa strategia viene rafforzata: il modello mantiene contesti nell’ordine del milione di token e introduce parametri di controllo del livello di thinking, insieme a miglioramenti nella gestione delle referenze interne e delle citazioni. La variante Gemini 3 Flash usa la stessa famiglia di modelli con latenze e costi inferiori per casi d’uso più leggeri, come chatbot ad alto volume, assistenti nel supporto clienti e integrazioni dirette in pagine web e app.
OpenAI ha seguito un approccio più graduale sul contesto, strettamente legato al reasoning. GPT-4o offre 128k token, un valore già elevato per molte applicazioni. GPT-4.1 ha portato la soglia a 1 milione, in contesti mirati per sviluppatori e aziende che lavorano con documenti lunghi. GPT-5 ha introdotto modalità di ragionamento in cui viene privilegiata la qualità della catena logica rispetto al semplice aumento meccanico della finestra. Il modello valuta da solo quando è utile espandere il reasoning interno e quando è sufficiente un ragionamento compatto, con risultati misurabili su benchmark come SWE-Bench e AIME. GPT-5 Pro ha esteso questa logica, offrendo profili dedicati a scenari agentici, con sessioni lunghe che accumulano stato e pianificazione.
In questa sezione si presta molto bene un confronto visivo tra le finestre di contesto effettive dei modelli e tra le generazioni successive di GPT e Gemini.
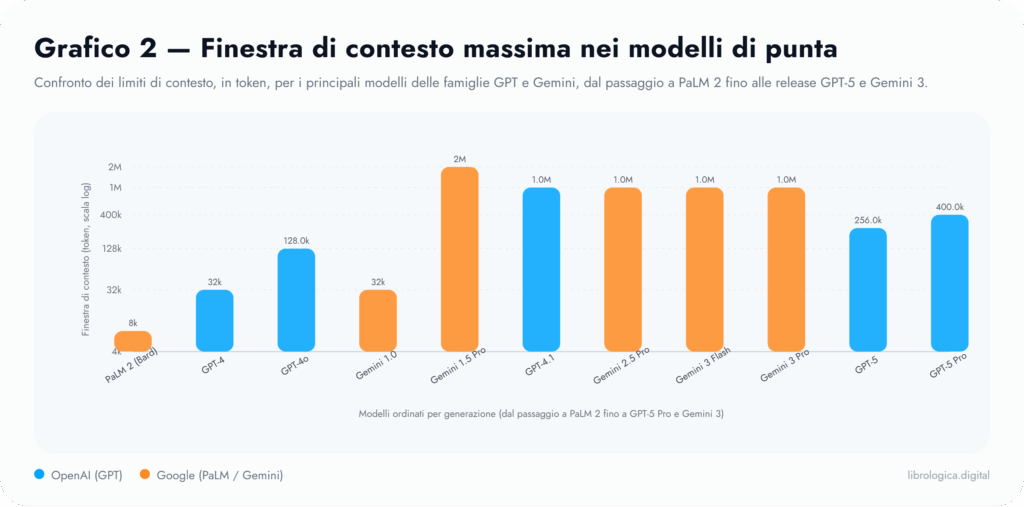
Il grafico permette di comprendere come Google abbia spinto con forza sulla leva del contesto, mentre OpenAI ha scelto una combinazione di contesto ampio e ragionamento avanzato, raggiungendo soglie elevate nelle release più recenti.
L’altro elemento chiave è il tipo di architettura. OpenAI con GPT-4o e GPT-5 punta a modelli veramente unificati per testo, visione e audio, senza pipeline separate. In questi modelli la stessa rete gestisce testo, immagini e suoni, con interpolazioni fluide tra i diversi formati. GPT-5 introduce un livello di orchestrazione interna che coordina sottomodelli specializzati per compiti diversi, come coding, matematica avanzata e interazione con strumenti esterni, ottenendo risultati record su benchmark complessi. La presenza di una variante GPT-5 Pro rende esplicita questa dimensione: l’architettura si presenta come una piattaforma interna di agenti coordinati, non solo come un singolo modello monolitico.
Google con Gemini insiste sul concetto di modello nativamente multimodale e di architettura pensata fin dall’inizio per gestire testo, immagini, audio e video in un unico spazio di rappresentazione. Nelle versioni 1.5 e 2.5 Pro, e poi in Gemini 3 Pro, questo approccio viene ampliato con capacità di analisi video più profonde e con unione fra descrizione, ragionamento e generazione. In questo quadro Nano Banana e Nano Banana Pro diventano componenti specializzati per la generazione e l’editing di immagini fotorealistiche e stilizzate, che si appoggiano alla comprensione multimodale di Gemini per ottenere coerenza semantica.
Benchmarks: matematica, coding e comprensione generale
Quando si valuta chi sta costruendo il modello più avanzato, i benchmark forniscono un riferimento utile, pur con tutti i limiti di queste metriche. Offrono comunque un terreno condiviso dove confrontare le generazioni successive di GPT e Gemini e capire in quali aree ciascuno mostra un vantaggio.
OpenAI nel comunicato su GPT-5 indica risultati molto netti: 94,6 per cento su AIME 2025 in matematica senza strumenti esterni e 74,9 per cento su SWE-Bench Verified per la programmazione su repository reali. A queste prestazioni si è affiancata GPT-5 Pro, variante orientata a scenari agentici e flussi di lavoro più pesanti, che mantiene la stessa base di reasoning con margini ulteriori su compiti complessi. In pratica, GPT-5 è diventato un riferimento per problemi matematici avanzati, dimostrazioni strutturate, correzioni di codice distribuite su molteplici file e refactoring di progetti.
Gemini 2.5 Pro, secondo il blog ufficiale di Google e vari confronti indipendenti, raggiunge il 63,8 per cento su SWE-Bench Verified e supera GPT-4 su diversi benchmark di conoscenza generale e ragionamento scientifico, come MMLU e test specifici di problem solving. Con l’uscita di Gemini 3 Pro la linea si sposta ancora: Google dichiara un miglioramento netto rispetto a 2.5 Pro su tutti i benchmark principali, con risultati da stato dell’arte su arene pubbliche come LMArena e WebDev Arena e un forte incremento nelle prove multimodali avanzate come MMMU-Pro e Video-MMMU. Ciò indica un consolidamento del profilo di Gemini come modello bilanciato, efficace su conoscenza generale, ragionamento, linguaggi di programmazione e input multimodali.
Per la comprensione linguistica generale, GPT-4o alla sua introduzione ha ottenuto 88,7 punti su MMLU, oltre il valore di GPT-4, e mostra miglioramenti anche nelle lingue non inglesi. GPT-5 prosegue su questa traiettoria, con punteggi ancora più elevati nei test di comprensione multilingua. Gemini 2.5 Pro viene accreditato di circa 90,3 punti nello stesso benchmark secondo analisi comparative di terze parti, e Gemini 3 Pro migliora ulteriormente alcuni sottoinsiemi di MMLU, soprattutto nelle discipline scientifiche e tecniche.
In questa sezione conviene prevedere due grafici distinti che permetteranno di affiancare in modo intuitivo coding e comprensione generale.
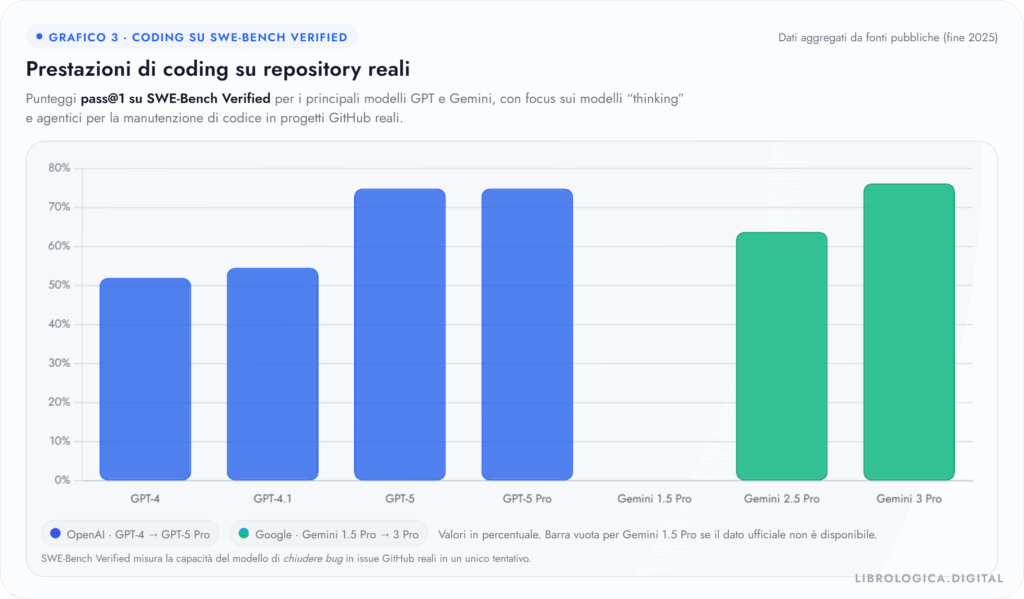
Il grafico raffigura i punteggi su SWE-Bench Verified per una serie di modelli allineati: GPT-4, GPT-4.1, GPT-5, GPT-5 Pro, Gemini 1.5 Pro, Gemini 2.5 Pro, Gemini 3 Pro. Per GPT-5 abbiamo il 74,9 per cento indicato da OpenAI, per Gemini 2.5 Pro il 63,8 per cento comunicato da Google, per GPT-4 e GPT-4.1 i valori riportati da analisi indipendenti e dal sito di OpenAI, che mostrano un progressivo avvicinamento alla soglia dei due terzi dei problemi risolti prima di arrivare alla generazione 5.
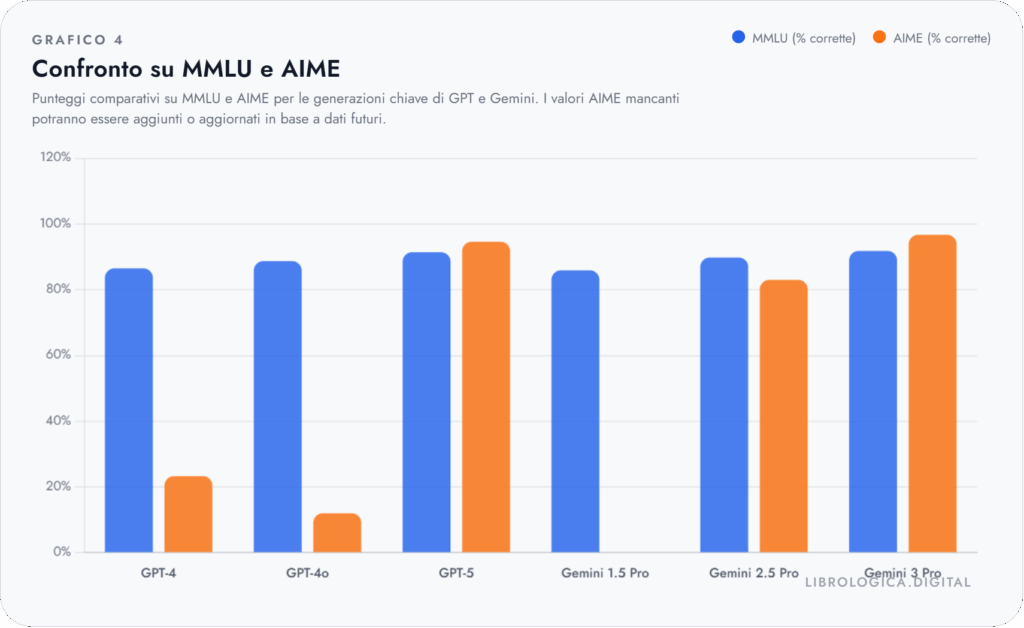
Qui abbiamo due gruppi di barre per ciascun modello. Il primo gruppo per MMLU con i valori noti di GPT-4, GPT-4o, GPT-5 e delle versioni chiave di Gemini, ad esempio Gemini 1.5 Pro, Gemini 2.5 Pro e Gemini 3 Pro, secondo i dati pubblici e le stime più consolidate. Il secondo gruppo per AIME, dove GPT-5 raggiunge il 94,6 per cento, mentre i valori di GPT-4, GPT-4o e delle diverse generazioni di Gemini restano più bassi. Il grafico aiuta a capire in quali ambiti il gap tra i due ecosistemi risulta più marcato e in quali direzioni Google concentra gli sforzi per ridurre questa distanza
Dai benchmark emerge una fotografia piuttosto chiara: Google avanza forte sul fronte del contesto e della comprensione multimodale integrata, con prestazioni elevate e bilanciate. OpenAI si concentra sul ragionamento più profondo, in particolare in matematica e coding, e ottiene i valori più alti nei test che misurano queste capacità. I due approcci si influenzano a vicenda e tendono progressivamente a convergere verso un profilo in cui contesto lungo, reasoning avanzato e multimodalità sono tutti elementi essenziali.
Adozione reale: utenti, traffico e casi d’uso
La sfida tra OpenAI e Google si gioca anche sul numero di persone che utilizzano quotidianamente i loro modelli e sul tipo di attività che questi strumenti supportano. L’adozione reale si misura in utenti, traffico, tempo di utilizzo, ma anche nella profondità con cui i modelli entrano nei processi aziendali e creativi.
Dal lato OpenAI, ChatGPT è stato il servizio consumer che ha raggiunto più rapidamente 100 milioni di utenti, già a inizio 2023. Nel 2025, secondo varie fonti e conferme pubbliche, ChatGPT arriva a circa 700–800 milioni di utenti attivi settimanali, con oltre 2 miliardi di prompt al giorno. A questa base si aggiungono gli utenti che interagiscono con GPT-4o, GPT-4.1, GPT-5 e GPT-5 Pro tramite API, integrazioni personalizzate, prodotti terzi e agenti verticali. L’ecosistema dei GPT customizzati amplifica questa diffusione, perché permette a singoli creatori e aziende di costruire interfacce su misura che restano comunque ancorate ai modelli OpenAI.
Google con Gemini si muove in modo diverso. Le statistiche di traffico mostrano che nel 2024 la versione web di Gemini/Bard ha ricevuto in media oltre 140 milioni di visite al mese, con una crescita costante nel 2025. Nel marzo 2025 Google ha indicato circa 350 milioni di utenti attivi mensili, saliti oltre 400 milioni entro l’estate, grazie anche all’integrazione nei prodotti Google e nelle AI Overviews della ricerca. A questo si aggiunge l’uso silenzioso di Gemini all’interno di Gmail, Documenti, Fogli, Slides, dell’app Google sui telefoni Android e, progressivamente, del nuovo assistente Gemini integrato nel sistema operativo.
Questa differenza va interpretata con attenzione. ChatGPT ha una base utenti estremamente ampia e trasversale, che accede al modello in modo esplicito attraverso il sito o le app ufficiali. Gemini si appoggia su un ecosistema che comprende ricerca, YouTube, Android, Workspace. Una parte degli utenti sperimenta i modelli di Google senza cercarli in modo diretto, per esempio tramite funzioni integrate in Gmail per la scrittura assistita, nelle AI Overviews nei risultati di ricerca o negli strumenti video che usano Veo per suggerire modifiche.
Per chiarire il confronto è utile introdurre un grafico dedicato all’adozione, che evidenzi sia la crescita organica sia l’effetto delle integrazioni nei prodotti di massa.
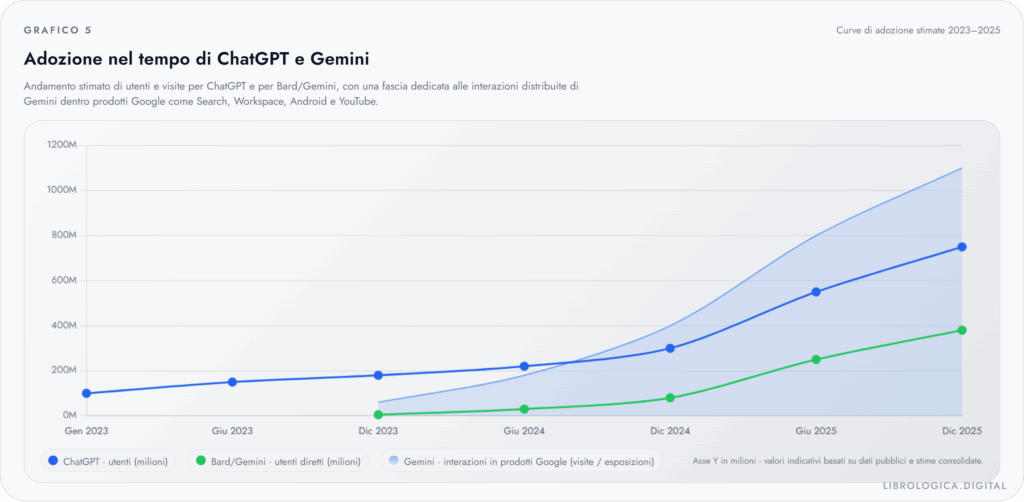
In questo grafico abbiamo due linee temporali. La prima per ChatGPT, con punti indicativi come 100 milioni di utenti mensili a gennaio 2023, circa 300 milioni di utenti settimanali a fine 2024 e fino a 700–800 milioni nel 2025, sulla base dei dati OpenAI e delle analisi statistiche più recenti. La seconda linea per Bard/Gemini, con i livelli di traffico e gli utenti attivi mensili riportati dalle analisi sul 2024 e 2025, partendo da circa 30 milioni di visite nel marzo 2024 fino a oltre 1 miliardo di visite mensili e 350–400 milioni di utenti attivi nel 2025. Il grafico include anche un’ombra che indica gli utenti che incontrano Gemini all’interno di altri prodotti, offrendo così una stima visiva della presenza distribuita del modello. Il grafico evidenzia che OpenAI mantiene un vantaggio in termini di coinvolgimento diretto sull’assistente, mentre Google si avvicina rapidamente sul piano del volume complessivo di interazioni, soprattutto grazie alla capillarità della propria infrastruttura. In prospettiva, i due numeri potrebbero convergere ulteriormente con il rafforzarsi delle integrazioni nei sistemi operativi, nei browser e nelle grandi suite di produttività.
Immagini e video: GPT-Image, Imagen e Veo contro Sora
La competizione tra OpenAI e Google non riguarda solo i modelli testuali. Entrambe le aziende stanno investendo molto nella generazione di immagini e video, con approcci che si intrecciano con i loro LLM e che incidono direttamente sui flussi creativi di designer, content creator, marketer e sviluppatori.
OpenAI, dopo DALL-E 3, ha introdotto GPT-4o come modello multimodale in grado di generare immagini direttamente dall’interfaccia di ChatGPT. Nel marzo 2025 viene presentato GPT Image 1, descritto come successore nativo di DALL-E 3 integrato nell’ecosistema GPT-4o, con capacità migliorate nel seguire istruzioni dettagliate, nella gestione dei testi all’interno delle immagini e nella coerenza tra più soggetti. Gli utenti possono passare dalla richiesta testuale alla generazione di immagini senza cambiare strumento, con un flusso che mantiene la storia della conversazione e le preferenze stilistiche.
Sul fronte video, OpenAI ha annunciato Sora nel febbraio 2024 come modello text-to-video in grado di generare clip fino a un minuto. Nei mesi successivi Sora viene reso disponibile prima a gruppi ristretti e poi al pubblico in nord America, con una seconda generazione, Sora 2, rilasciata nel 2025 e integrata più strettamente in ChatGPT e nelle API. Sora 2 introduce maggiore coerenza temporale, migliore controllo del movimento di camera e possibilità di specificare con più precisione lo stile visivo. L’integrazione con i modelli testuali consente a sviluppatori e creativi di costruire storyboard, sceneggiature e video finali in un unico flusso.
Google ha risposto con Imagen 3 per la generazione di immagini ad alta qualità, integrata sia in Gemini sia nei flussi di lavoro Cloud. Il modello offre un controllo fine sul formato, sulla qualità dei dettagli e sui testi sovrapposti, con esempi ufficiali che mostrano creazione di loghi, illustrazioni editoriali, mockup per campagne pubblicitarie e grafiche pronte per l’uso. Imagen 3 viene esposto tramite Gemini, Google AI Studio e servizi cloud, rendendo possibile un utilizzo tanto consumer quanto enterprise.
Accanto a Imagen 3 Google ha introdotto Nano Banana, modello di generazione e editing immagini corrispondente alla variante Gemini 2.5 Flash Image, diventato rapidamente popolare per le figurine tridimensionali fotorealistiche, per i personaggi stilizzati e per la facilità con cui produce scene coerenti a partire da prompt brevi. Nano Banana è pensato per risposte rapide, anteprime e contenuti social. Nel novembre 2025 è arrivato Nano Banana Pro, costruito sul framework di Gemini 3 Pro Image, con testo multilingue più leggibile, maggiore coerenza tra più soggetti, controlli di editing avanzati su luce, inquadratura e colore e output fino a 2K e 4K. Questa versione viene integrata nella app Gemini, in Google Ads, in Google AI Studio e, tramite partnership, in strumenti come Photoshop e Firefly, rafforzando la posizione di Google nelle pipeline creative ibride testo–immagine.
Sul versante video Google ha proposto Veo, presentato nel 2024 e arrivato alla versione Veo 3.1 nel 2025. Veo genera video ad alta definizione in diversi formati, supporta prompt dettagliati e consente di controllare durata, stile e movimento. L’integrazione con YouTube e con gli strumenti per creator consente di usare Veo per trailer, contenuti social, bozze di montaggio e visual concept.
Conclusioni
Il confronto tra OpenAI e Google nell’intelligenza artificiale generativa mostra due strategie ben definite che si sono intrecciate nel corso di pochi anni. Da un lato OpenAI ha costruito un percorso centrato sul ragionamento, sulla capacità di seguire catene di pensiero lunghe, sulla solidità nel coding e nella matematica avanzata. Dall’altro Google ha scelto di spingere in modo aggressivo sulla profondità del contesto, sulla multimodalità estesa e sull’integrazione capillare di Gemini dentro l’ecosistema Search, Workspace, Android e YouTube, trasformando i propri modelli in una infrastruttura diffusa più che in un singolo prodotto.
I grafici aiutano a vedere con chiarezza questa divergenza di priorità. La timeline dei modelli mostra un rincorrersi continuo di rilasci, con OpenAI che introduce miglioramenti nella qualità del reasoning e Google che risponde alzando il limite di contesto e ampliando la gamma Gemini. Il confronto sulle finestre di contesto mette in evidenza un primato netto di Google iniziato con Gemini 1.5 Pro e proseguito con le versioni successive, che rimangono su valori dell’ordine del milione di token, mentre OpenAI lavora su un equilibrio diverso tra contesto ampio e precisione nelle risposte, portando comunque GPT-5 su soglie elevate, adeguate alla maggior parte dei casi d’uso reali.
Quando si passa ai benchmark di coding e matematica avanzata, la curva cambia volto. Su SWE-Bench Verified GPT-5 si colloca in una fascia alta, vicina ai tre quarti dei problemi risolti, consolidando un vantaggio nei compiti che richiedono interventi su codice reale e gestione di repository complessi. Gemini 2.5 Pro e Gemini 3 Pro mostrano progressi consistenti e una tendenza di crescita regolare, ma restano in una zona leggermente inferiore. Il grafico su MMLU e AIME rafforza questa impressione: sui test di conoscenza generale la distanza tra GPT-5 e Gemini 3 Pro è ridotta, mentre sulle prove matematiche più selettive la generazione 5 di OpenAI tocca punte di accuratezza molto difficili da raggiungere, con valori di AIME che si avvicinano a performance di livello olimpico.
ChatGPT è cresciuto rapidamente e ha raggiunto centinaia di milioni di utenti, diventando un’interfaccia diretta molto riconoscibile. Bard e poi Gemini sono partiti con numeri inferiori, poi hanno accelerato grazie alla distribuzione nelle proprietà Google e a un’integrazione silenziosa dentro prodotti che milioni di persone hanno usato ogni giorno. Nel grafico sull’adozione la linea di ChatGPT ha conservato un vantaggio nell’uso diretto, mentre l’area dedicata alle interazioni di Gemini nei servizi di Google ha suggerito una presenza potenziale enorme, spesso passata sotto traccia come uso esplicito di un modello linguistico, pur avendo inciso in modo significativo sulle abitudini di ricerca, scrittura e produttività.
Da questo quadro emerge una conclusione più articolata rispetto alla classica domanda su chi vincerà. Nel breve periodo è plausibile che OpenAI mantenga un vantaggio nei contesti in cui contano la qualità del reasoning, la robustezza nel coding, l’affidabilità sui benchmark più duri e l’esperienza d’uso centrata su ChatGPT e sulle API per sviluppatori. Google appare favorito negli scenari in cui è decisivo incrociare enormi quantità di contenuti, sfruttare contesti lunghissimi, combinare testo, immagini, video e interazione con il mondo mobile, e dove l’integrazione nativa con l’ecosistema Google offre un vantaggio strategico.
Nel medio termine si possono delineare almeno tre scenari plausibili. Nel primo scenario OpenAI consolida il ruolo di punto di riferimento per chi sviluppa strumenti professionali, ambienti di lavoro agentici e applicazioni complesse, mentre Google diventa il motore invisibile che sostiene la maggior parte delle interazioni quotidiane con l’intelligenza artificiale in ambito consumer e office. In un secondo scenario Google riduce ulteriormente il divario sui benchmark più selettivi e sfrutta la propria base utenti per attrarre sviluppatori e aziende, spingendo Gemini come piattaforma di riferimento tanto quanto oggi lo è la coppia GPT-5 e API OpenAI. In un terzo scenario, che oggi appare il più realistico, i due ecosistemi continuano a evolversi in parallelo: alcuni settori sceglieranno prevalentemente OpenAI, altri si appoggeranno in modo quasi esclusivo a Google, e una parte crescente del mercato costruirà soluzioni ibride, selezionando di volta in volta il modello più adatto in base al contesto, al costo e al tipo di problema da risolvere.

