I modelli di frontiera affrontano attività sempre più complesse e alcuni protagonisti del settore sostengono che l’intelligenza artificiale generale sia già arrivata. Per capire quanto sia fondata questa affermazione occorre chiarire il traguardo, leggere correttamente i risultati e distinguere le capacità presenti dalle previsioni.
Potremmo attraversare la soglia dell’AGI continuando a discutere dell’aggiornamento appena uscito. Un modello programma meglio, un altro risolve un problema scientifico, un agente porta avanti un progetto che fino a poco prima richiedeva un gruppo di persone. Ogni risultato diventa una notizia separata, viene confrontato con quello precedente e lascia rapidamente spazio al successivo. Nel frattempo, la domanda che per anni ha accompagnato il dibattito sull’intelligenza artificiale sembra quasi perdersi fra le versioni dei prodotti. Quanto manca a una macchina capace di affrontare un insieme molto ampio di attività intellettuali con la flessibilità di una persona?
L’impressione che questo tema sia passato in secondo piano merita però una precisazione. All’interno del settore la discussione continua, e negli ultimi mesi ha assunto toni particolarmente espliciti. Greg Brockman ha parlato di ingresso nell’era dell’AGI durante il lancio di GPT-6 Astra. Jensen Huang aveva già dichiarato di ritenerla raggiunta. Altri ricercatori considerano ancora insufficienti le dimostrazioni disponibili. Il dibattito, quindi, esiste: la cronaca quotidiana dei prodotti tende a disperderlo fra annunci che vengono spesso letti come miglioramenti isolati, anche quando riguardano proprio le capacità che avevamo associato all’arrivo dell’intelligenza generale.
Che cosa intendiamo per intelligenza generale
AGI deriva da Artificial General Intelligence, espressione traducibile con intelligenza artificiale generale. Il nucleo dell’idea è la capacità di usare ciò che si sa per affrontare problemi differenti, acquisire competenze nuove e trasferirle fra contesti. Un sistema specializzato può ottenere risultati eccezionali all’interno di un’attività precisa. Un sistema generale dovrebbe riuscire ad adattarsi a una varietà di richieste, comprese quelle per le quali nessuno ha preparato una soluzione specifica. Il punto decisivo riguarda quindi l’ampiezza dell’adattamento e il modo in cui vengono acquisite e impiegate le competenze.
La difficoltà nasce quando si cerca di stabilire quanta generalità e quale livello di prestazione siano sufficienti. Una macchina che affronta numerosi argomenti con risultati discreti soddisfa un criterio relativamente ampio. Un sistema che svolge autonomamente la maggior parte delle attività professionali qualificate supera una soglia molto più impegnativa. Se poi si pretende che eccella in ogni compito, si introduce un requisito ulteriore, difficilmente applicabile persino agli esseri umani. Molte discussioni contrappongono risposte diverse a domande che, esaminate attentamente, sono già diverse in partenza.
La Carta di OpenAI adotta un criterio legato al lavoro: sistemi altamente autonomi, capaci di superare gli esseri umani nella maggior parte delle attività economicamente rilevanti. In questa definizione l’autonomia è un requisito esplicito accanto alla competenza. Produrre un’ottima risposta è una parte del percorso; arrivare a un risultato utile attraverso una sequenza di decisioni richiede ulteriori capacità. Anche l’espressione “maggior parte” conta, perché lascia spazio a eccezioni. Il traguardo descritto dalla Carta riguarda una superiorità molto estesa sul piano operativo, senza richiedere una perfezione assoluta in qualsiasi situazione concepibile.
Un gruppo di ricercatori di Google DeepMind ha proposto un’impostazione diversa e complementare nel lavoro Levels of AGI. La generalità e il livello delle prestazioni vengono trattati come dimensioni distinte. Si può essere ampi nelle competenze e ancora modesti nei risultati, oppure straordinari in un ambito ristretto. Il quadro distingue inoltre le capacità dall’autonomia con cui vengono impiegate. L’AGI diventa così un percorso con diversi livelli, anziché una qualifica assegnata attraverso un’unica prova.
La stessa distinzione aiuta a separare l’intelligenza generale dalla coscienza. Risolvere problemi, apprendere e pianificare sono capacità osservabili attraverso il comportamento. L’esistenza di un’esperienza soggettiva appartiene a un’altra domanda. Anche il possesso di un corpo robotico dipende dalla definizione adottata: un’AGI impegnata nel lavoro digitale può essere valutata senza pretendere che sappia muoversi in una cucina. I criteri proposti in Levels of AGI consentono proprio questa separazione. Un eventuale riconoscimento dell’AGI, dunque, riguarderebbe determinate capacità, lasciando aperte altre questioni sulla natura della mente.
Nel marzo 2026 Google DeepMind ha aggiunto un nuovo contributo, proponendo un quadro di valutazione fondato su dieci facoltà cognitive. Fra queste compaiono apprendimento, memoria e metacognizione, cioè la capacità di monitorare il proprio funzionamento. L’obiettivo è costruire un profilo articolato del sistema attraverso prove mirate e confronti con le persone. È un passaggio significativo anche per capire lo stato del dibattito: mentre i modelli migliorano, la ricerca sta ancora mettendo a punto gli strumenti con cui descrivere in modo convincente la loro generalità. La domanda sull’AGI riguarda anche la qualità delle nostre misure.
Le capacità che stanno cambiando il confronto
Nel frattempo, la crescita delle capacità è diventata difficile da liquidare come un semplice miglioramento della conversazione. OpenAI ha presentato GPT-6 Astra a settembre 2026 descrivendo avanzamenti nel lavoro al computer, nella programmazione e nelle attività scientifiche. Anthropic ha pubblicato Claude Fable 5.2 il 9 novembre, a distanza di poche settimane da altri aggiornamenti della propria gamma. La frequenza delle uscite può generare assuefazione, perché ogni nuovo risultato viene confrontato immediatamente con il precedente. Il confronto storico, su intervalli più lunghi, rende molto più evidente il cambiamento nella complessità dei compiti affrontati.
La matematica offre un esempio particolarmente leggibile. Nel luglio 2025 una versione avanzata di Gemini Deep Think ha raggiunto lo standard da medaglia d’oro alle Olimpiadi internazionali di matematica, con cinque problemi risolti su sei e 35 punti su 42. Il risultato è stato valutato ufficialmente dai coordinatori della competizione. Si trattava di una versione avanzata del sistema, distinta dal semplice uso di un assistente disponibile a tutti. È comunque un riferimento importante: il ragionamento richiesto da quelle prove era già molto lontano dalla generazione di testi plausibili su argomenti familiari.
Nel febbraio 2026 DeepMind ha descritto il lavoro di Aletheia, un agente costruito intorno a Gemini Deep Think per generare soluzioni matematiche, verificarle e rivederle. Il programma di ricerca ha prodotto contributi a problemi professionali, con differenti gradi di autonomia e intervento umano. A novembre Anthropic ha riferito un altro risultato impressionante: la formalizzazione della dimostrazione dell’ultimo teorema di Fermat in trenta ore, in una prova con circa mille agenti Fable 5.2 e un intervento umano minimo. Formalizzare una dimostrazione già conosciuta significa tradurla in passaggi controllabili da un sistema di verifica. La scoperta di una dimostrazione originale sarebbe un risultato di natura diversa, e il valore del lavoro svolto può essere riconosciuto mantenendo chiara questa distinzione.
Questi progressi autorizzano una conclusione precisa. Le AI stanno entrando in attività che richiedono passaggi intermedi, controllo dei risultati e competenze specialistiche. Il salto verso l’AGI dipende però dalla possibilità di estendere tali capacità a contesti molto differenti. Un’ottima prestazione matematica dimostra qualcosa sulla matematica; per descrivere una generalità robusta occorre capire come il sistema se la cavi quando cambiano la materia, gli strumenti e il criterio di successo. Il merito di una prova rimane intatto anche quando si evita di attribuirle un significato più ampio di quello effettivamente misurato.
Che cosa misurano i benchmark
Un caso istruttivo arriva da ARC-AGI-3, una valutazione nella quale gli agenti esplorano ambienti interattivi sconosciuti e devono ricavarne le regole. Nel settembre 2026 ARC Prize ha misurato per GPT-6 Astra un punteggio del 62,7% con la propria configurazione standard e del 99,9% con un adattatore che conserva lo stato di ragionamento fra le richieste e gestisce il contesto delle interazioni prolungate. I due risultati si riferiscono anche a livelli diversi di elaborazione. La configurazione del sistema contribuisce quindi in modo sostanziale alla prestazione osservata.
La stessa ARC Prize precisa che la saturazione di questa prova lascia aperta la questione dell’AGI, perché gli ambienti restano delimitati e deterministici. Il risultato documenta un avanzamento importante nell’apprendimento attraverso l’interazione. Per attribuire una capacità generale più ampia servono ulteriori verifiche. Il nome di un benchmark può indicare la direzione della ricerca; il suo superamento conserva il significato stabilito dalle attività che contiene e dalle condizioni con cui viene eseguito.
Da qui emerge un tema spesso trascurato. L’oggetto da valutare può essere il modello isolato oppure l’intero sistema che lo mette al lavoro. Memoria, strumenti esterni e procedure di verifica modificano ciò che un agente riesce a fare. Per una valutazione operativa è ragionevole considerare il sistema completo, dichiarandone le risorse: anche una persona lavora con documenti, applicazioni e appunti. Diventa però essenziale distinguere ciò che viene deciso dall’agente da ciò che è stato predisposto da chi lo ha costruito. La generalità si misura anche nella capacità di scegliere e adattare gli strumenti a una situazione nuova.
L’autonomia si misura lungo il lavoro
L’autonomia introduce poi la dimensione del tempo. Il gruppo di ricerca METR ha studiato l’orizzonte dei compiti che i modelli riescono a completare con una determinata probabilità. La durata viene espressa attraverso il tempo necessario a un esperto umano. Un orizzonte di alcune ore al 50% indica quindi la difficoltà temporale del compito per una persona e una probabilità stimata di successo dell’agente pari alla metà. Questa misura va tenuta distinta dal numero di ore durante le quali un programma resta acceso o continua a produrre attività.
La revisione pubblicata da METR nel gennaio 2026 conferma una crescita rapida degli orizzonti, con raddoppi nell’ordine dei mesi e stime sensibili alla selezione dei compiti. La dashboard pubblica, il cui aggiornamento attivo risulta interrotto dall’8 settembre, avverte inoltre che le misure oltre sedici ore sono poco affidabili con quella raccolta di prove. Una linea crescente aiuta a osservare una tendenza; trasformarla automaticamente nella data dell’AGI richiederebbe ipotesi aggiuntive. Soprattutto, completare metà dei compiti di una certa difficoltà e portarli a termine quasi sempre sono condizioni operative molto differenti.
È qui che l’esperienza quotidiana può diventare un criterio utile, purché venga raccolta in modo sistematico. Un assistente capace di aiutare durante ogni passaggio di un progetto offre già un valore notevole. Un agente a cui affidare un obiettivo generale deve anche riconoscere le informazioni mancanti, mantenere la coerenza del lavoro e accorgersi quando una strada sta fallendo. Per parlare di autonomia convincente occorre verificare queste qualità lungo l’intero processo. Il risultato finale conta più della quantità di testo prodotto o del numero di operazioni eseguite nel frattempo.
L’AGI è già arrivata? Le posizioni a confronto
Alla luce di tutto questo, sostenere che l’AGI sia già arrivata può avere un fondamento? Sì, quando la definizione privilegia la generalità e ammette una prima fase ancora disomogenea nelle prestazioni. Blaise Agüera y Arcas e Peter Norvig hanno difeso esplicitamente questa posizione nel saggio Artificial General Intelligence Is Already Here, pubblicato nel 2023. Secondo i due autori, i modelli di frontiera avevano già acquisito la proprietà essenziale di affrontare attività nuove in numerosi ambiti. I progressi successivi avrebbero consolidato una forma di intelligenza generale già riconoscibile, proprio come una tecnologia può appartenere a una nuova categoria fin dalle sue prime versioni imperfette.
Questa tesi ha una forza logica che merita attenzione. Se la parola “generale” descrive l’estensione delle competenze, pretendere una superiorità assoluta prima di usarla aggiunge un requisito diverso. D’altra parte, chi utilizza AGI per indicare un’intelligenza professionale autonoma chiede una dimostrazione ulteriore. Entrambe le discussioni possono essere sensate, purché sia esplicitato il criterio. Una parte dello scontro nasce dal trattare come incompatibili due valutazioni che osservano dimensioni differenti della stessa tecnologia.
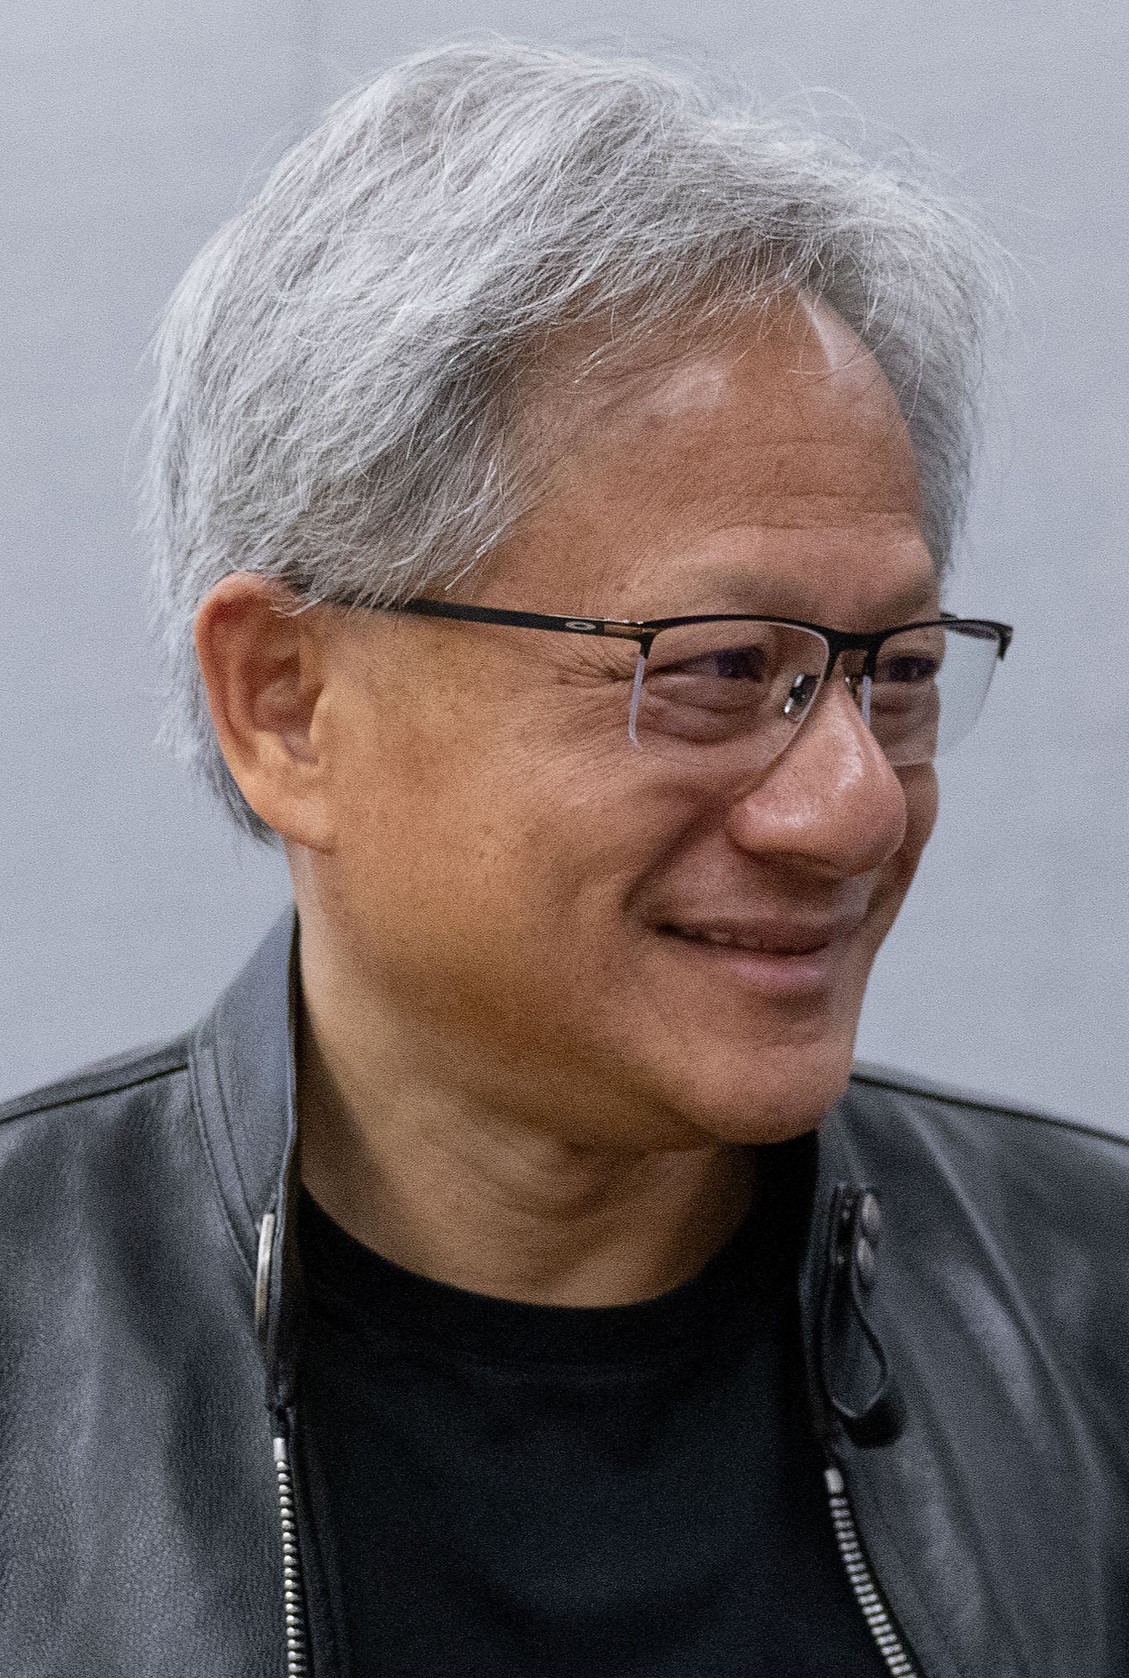
Jensen Huang ha assunto una posizione ancora più diretta nell’intervista a Lex Fridman pubblicata nel marzo 2026: «Penso che abbiamo raggiunto l’AGI». Il contesto chiarisce la portata della frase. La domanda riguardava la possibilità per un sistema di creare e gestire un’azienda tecnologica dal valore superiore a un miliardo di dollari. Huang ha ragionato sulla capacità di costruire un prodotto o un servizio di grande successo, anche temporaneo. La dichiarazione esprime una convinzione sulle possibilità degli agenti; nell’intervista manca una dimostrazione completa di un’impresa di quelle dimensioni costruita e amministrata autonomamente da un’AI.
Greg Brockman ha scelto una formulazione particolarmente interessante nell’intervista a Stratechery del 4 settembre 2026. A suo giudizio siamo entrati nell’era dell’AGI, lasciando aperto se la soglia verrà associata al modello precedente, ad Astra o a quello successivo. L’affermazione riguarda una fase storica nella quale diverse persone riconosceranno il superamento dei propri criteri. È una posizione più sfumata di un annuncio accompagnato da una certificazione condivisa, e suggerisce che l’arrivo dell’AGI potrebbe essere ricostruito a posteriori attraverso una successione ravvicinata di risultati.
Esiste anche una risposta critica documentata. Nel settembre 2026 l’AGI Society ha esaminato le dichiarazioni relative a GPT-6 Astra e ha giudicato le evidenze pubblicate ancora insufficienti per concludere che l’AGI fosse stata raggiunta. È il giudizio di un’associazione scientifica, con propri criteri, e va presentato come tale. Il suo interesse consiste nel richiamare l’attenzione sull’insieme delle capacità da dimostrare. Nelle fonti esaminate manca un verdetto universalmente riconosciuto che chiuda la questione per tutte le definizioni in uso.
La conclusione più solida, oggi, contiene dunque due affermazioni compatibili. Esistono argomenti seri per riconoscere nei modelli attuali forme iniziali di intelligenza generale. La dimostrazione di un’autonomia generale robusta, estesa a un’ampia varietà di attività complesse, rimane oggetto di valutazione. Usare la parola AGI specificandone il significato consente di discutere entrambe le possibilità. Pronunciarla come un titolo assoluto, separato da criteri osservabili, rende invece più difficile capire che cosa sia stato davvero ottenuto.
Un criterio operativo per un’AGI digitale robusta
Per rendere la discussione più concreta, potremmo adottare un criterio operativo dichiarato. Chiameremmo AGI digitale robusta un sistema capace di apprendere attività nuove, svolgere un insieme ampio di lavori cognitivi a un livello professionale e portare avanti progetti con una supervisione limitata. La valutazione dovrebbe avvenire su compiti inediti, tenuti separati dall’addestramento e dall’ottimizzazione del sistema, attraverso gruppi indipendenti e con risorse documentate. Questo è un criterio proposto per orientare l’analisi, senza attribuirgli il valore di uno standard internazionale già approvato. Serve soprattutto a rendere verificabile la domanda sui tempi.
Una verifica del genere dovrebbe considerare anche l’apprendimento durante il lavoro. Ricordare una preferenza attraverso un archivio esterno è utile; acquisire una nuova competenza e riutilizzarla correttamente in un contesto differente richiede qualcosa di più. La memoria disponibile, l’adattamento nel contesto e l’aggiornamento dei parametri del modello sono meccanismi distinti. L’esito pratico può emergere da una loro combinazione. La domanda interessante è quanto efficacemente il sistema trasformi l’esperienza in capacità utilizzabili, senza richiedere che ogni metodo di apprendimento riproduca quello biologico.
Anche il confronto con gli esseri umani va impostato con attenzione. Una persona competente può sbagliare, chiedere un chiarimento o consultare una fonte. Un criterio ragionevole deve confrontare qualità, affidabilità e risorse in condizioni comparabili. Pretendere l’infallibilità sposterebbe il traguardo verso un ideale estraneo al lavoro umano. Accettare qualsiasi risultato occasionalmente brillante lo abbasserebbe troppo. Il riferimento più utile è la capacità di ottenere esiti validi con continuità, riconoscendo i propri limiti abbastanza bene da gestire il compito in modo efficace.
Le previsioni dei laboratori e dei ricercatori
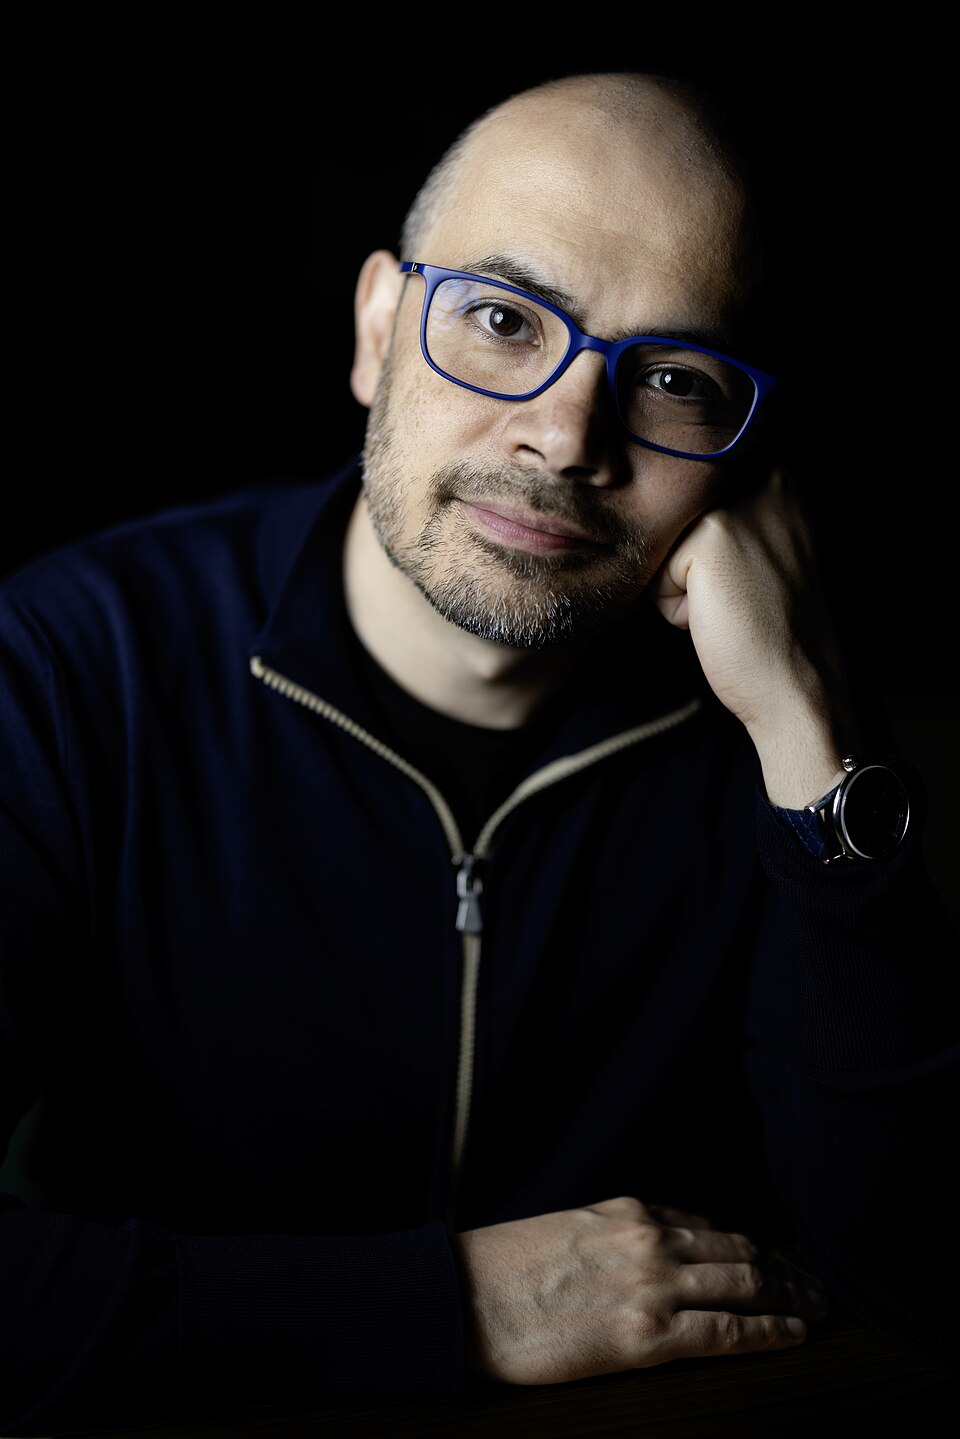
Quando potrebbe arrivare un sistema di questo tipo? Le previsioni restano molto diverse, anche fra chi guida i laboratori più avanzati. Nel maggio 2026 Hassabis ha indicato ad Axios il 2030, contemplando anche un arrivo nel 2029. Dario Amodei, nell’intervista a Dwarkesh Patel del febbraio 2026, ha parlato di uno o due anni, forse da uno a tre, per sistemi corrispondenti alla sua idea di un “paese di geni in un data center”. Ha associato alla finestra più vicina una fiducia approssimativamente del 50%, distinguendola dalla maggiore convinzione su un orizzonte più lungo.
La formulazione di Amodei descrive peraltro un obiettivo più ambizioso di un assistente versatile: capacità intellettuali molto elevate, attività prolungata e numerose copie del sistema al lavoro. Confrontare le sue date con quelle di altri richiede di tenere presente questa differenza. Un anno indicato durante un’intervista resta una previsione personale, anche quando proviene da chi dispone di informazioni tecniche privilegiate. La sua utilità aumenta se viene accompagnato dalle capacità attese e dalle condizioni necessarie per raggiungerle.
Allargando lo sguardo ai ricercatori emerge una distribuzione più ampia. Un’indagine di AI Impacts, condotta nel dicembre 2024 e pubblicata nel settembre 2026, ha raccolto le risposte di 1.580 studiosi. La previsione aggregata raggiunge il 50% nel 2042 per macchine capaci di svolgere ogni compito meglio e a costi inferiori rispetto ai lavoratori umani. La definizione è particolarmente esigente e le risposte precedono i risultati più recenti. Quel valore descrive le opinioni aggregate del campione sulla domanda proposta; attribuirgli il significato di una data scientificamente stabilita per qualsiasi forma di AGI sarebbe improprio.
La finestra 2027–2031: una stima condizionata
Alla luce delle evidenze disponibili, una finestra fra il 2027 e il 2031 è plausibile per il consolidamento di un’AGI digitale robusta secondo il criterio operativo qui proposto. È una stima editoriale condizionata, priva di una probabilità calcolata e distinta da un consenso scientifico. La sua base è il progresso già osservato nella generalità dei modelli, insieme alla crescita delle capacità di usare strumenti e gestire lavori complessi. La condizione decisiva è che tali progressi si traducano in continuità operativa e apprendimento efficace anche fuori dalle situazioni preparate per le dimostrazioni.
Nella traiettoria più rapida, fra il 2027 e il 2028, potrebbero emergere sistemi per i quali l’etichetta AGI risulti convincente in una vasta parte del lavoro digitale. Sarebbe necessario un ulteriore miglioramento nella gestione dei progetti e nella correzione autonoma degli errori. Questo scenario diventerebbe più credibile se valutazioni indipendenti mostrassero risultati solidi su incarichi nuovi e prolungati, con un intervento umano ridotto. Gli annunci dei produttori fornirebbero un primo indizio; la ripetibilità del risultato attraverso utilizzatori e contesti differenti darebbe maggiore forza alla conclusione.
Una traiettoria intermedia, fra il 2029 e il 2031, lascerebbe più tempo all’integrazione fra ragionamento, memoria e apprendimento. È un orizzonte compatibile con l’idea che le componenti necessarie stiano maturando a velocità diverse e che il sistema completo richieda ancora un lavoro consistente. Una traiettoria più lenta resta possibile qualora la capacità di adattarsi a situazioni realmente nuove o di mantenere l’affidabilità su progetti lunghi si rivelasse più difficile da consolidare. In quel caso, i progressi economici e scientifici potrebbero continuare anche durante un rinvio del riconoscimento di un’AGI robusta.
Questa stima riguarda un’intelligenza generale impegnata soprattutto attraverso interfacce digitali. Estenderla a qualsiasi attività fisica richiederebbe valutazioni ulteriori. Esiste poi una distanza fra disponibilità tecnica e diffusione: un sistema può dimostrare una capacità prima che questa diventi accessibile, conveniente e ben integrata nelle organizzazioni. Per un lettore, un professionista o una piccola impresa il passaggio più percepibile potrebbe arrivare quando un’attività complessa diventerà affidabile e sostenibile nell’uso quotidiano. La prima dimostrazione e il momento dell’adozione diffusa possono avere date differenti.
Dall’AGI alla superintelligenza
La prospettiva dell’ASI apre un’altra scala di confronto. La sigla deriva da Artificial Superintelligence e indica una superintelligenza artificiale, capace di superare ampiamente il livello umano in un insieme molto esteso di attività cognitive. Una prestazione sovrumana isolata lascia ancora aperta questa qualificazione generale. Per discutere seriamente di ASI bisogna chiedersi quanto siano estese la superiorità, la capacità di apprendere e quella di produrre nuove conoscenze. La distanza da colmare dipende quindi dalla definizione di AGI con cui si è iniziato il percorso.
Il rapporto di Google DeepMind From AGI to ASI, pubblicato nel giugno 2026 e aggiornato a novembre, propone un confronto con capacità superiori a quelle di grandi organizzazioni umane. Esamina percorsi attraverso maggiore scala, nuovi paradigmi, collettivi di agenti e miglioramento ricorsivo. Il quadro prospetta una successione di avanzamenti, lasciando aperta la velocità del passaggio fra i diversi livelli.
Quando l’AI accelera la ricerca sull’AI
Anche OpenAI descrive il miglioramento ricorsivo nel documento Building standards for the next phase of AI, pubblicato a settembre 2026. L’idea è che sistemi sempre più capaci contribuiscano allo sviluppo delle generazioni successive, anche con persone ancora coinvolte nel processo. Un agente potrebbe aiutare a progettare algoritmi migliori, organizzare esperimenti e interpretarne i risultati. La prospettiva diventa particolarmente interessante quando questi contributi producono vantaggi che si accumulano: una generazione migliore potrebbe rendere più efficace il lavoro necessario per sviluppare quella successiva.
Un aggiornamento rilevante è arrivato il 5 novembre 2026 da METR, dopo una valutazione svolta all’interno di Anthropic. Il gruppo stima che il ritmo di miglioramento delle capacità su compiti ben definiti sia circa doppio rispetto al periodo di riferimento precedente e ritiene probabile un contributo importante dell’uso delle AI. Il rapporto dichiara un’elevata incertezza e precisa che una parte sostanziale delle evidenze interne è stata oscurata dall’azienda. Il lavoro osservato continua a coinvolgere in misura rilevante ricercatori umani assistiti dai sistemi. Il risultato documenta un possibile meccanismo di accelerazione, senza dimostrare una ricerca completamente autonoma.
Il 10 novembre AI Futures Project ha aggiornato le proprie previsioni, indicando il 2027 come probabile orizzonte per un ricercatore AI sovrumano, in assenza di rallentamenti deliberati sostanziali. Il rapporto METR ha avuto un ruolo centrale nella revisione. Si tratta della valutazione di un gruppo di previsione, costruita attraverso ipotesi ed estrapolazioni. La soglia riguarda in particolare la ricerca sull’AI; attribuire a quel risultato una superiorità generale in ogni dominio richiederebbe un passaggio ulteriore. La previsione mostra comunque quanto rapidamente possano cambiare le aspettative quando compare un’evidenza di accelerazione del processo di sviluppo.
Il lavoro collettivo offre un’altra possibilità. Molti agenti potrebbero suddividere un problema e confrontare soluzioni. Il guadagno dipenderebbe dalla capacità di coordinare i contributi e verificarne la qualità. Una parte della futura superiorità potrebbe quindi emergere dall’organizzazione complessiva di modelli e strumenti, oltre che dalle prestazioni di ogni singolo componente.
Gli scenari per l’ASI e i vincoli materiali
Per l’ASI proponiamo una proiezione editoriale ancora più incerta. Un’accelerazione stabile della ricerca potrebbe comprimere a pochi anni l’intervallo dopo l’AGI; tempi sperimentali e vincoli produttivi potrebbero prolungarlo. Se l’AGI robusta maturasse nella finestra discussa, forme ampie di ASI negli anni Trenta diventerebbero uno scenario plausibile. La previsione andrebbe riconsiderata alla luce delle capacità effettivamente raggiunte.
Una superintelligenza continuerebbe inoltre a operare attraverso informazioni e risorse finite. Una teoria sul mondo richiede osservazioni adeguate; una scoperta scientifica acquista forza attraverso verifiche. Essere molto più capaci degli esseri umani consentirebbe di impiegare meglio tali risorse e di formulare ipotesi più efficaci. La possibilità di conoscere ogni cosa o di ottenere istantaneamente qualunque risultato appartiene a una concezione assai più estrema. Tenere concreto il significato dell’ASI permette di apprezzarne le potenzialità senza attribuirle proprietà magiche.
Che cosa potrebbe cambiare nella pratica
Per la ricerca e per la produzione culturale, la prospettiva più interessante è l’ampliamento di ciò che può essere tentato. Un gruppo piccolo potrebbe esplorare progetti che oggi richiedono competenze difficili da riunire. Un ricercatore potrebbe verificare molte più ipotesi prima di scegliere quelle da portare in laboratorio. Un autore potrebbe sviluppare un’opera complessa accompagnandone la scrittura con strumenti di analisi e produzione sempre più capaci. Il valore concreto dipenderebbe dalla qualità del lavoro ottenuto e dall’accessibilità dei sistemi, anche durante gli anni in cui la classificazione teorica continuasse a essere discussa.
L’AGI merita quindi di tornare al centro del discorso proprio adesso. Le capacità che dovrebbero avvicinarci al traguardo stanno entrando nei prodotti, nei laboratori e nei processi di lavoro. Alcuni osservatori riconoscono già una prima forma di generalità; altri attendono dimostrazioni più estese di autonomia e apprendimento. Fra queste posizioni esiste uno spazio di ricerca concreto, fatto di prove ripetibili e criteri dichiarati. È lì che possiamo misurare la distanza residua, aggiornando le previsioni quando cambiano le evidenze.
Potremmo ricordare questi anni come il periodo in cui l’intelligenza generale è diventata riconoscibile attraverso una successione di risultati, prima di ricevere un nome condiviso. Per le sue forme iniziali esistono già argomenti seri; per un’AGI digitale robusta i prossimi anni offrono una finestra plausibile e verificabile. La superintelligenza resta un orizzonte successivo, la cui distanza dipenderà anche da quanto efficacemente le AI sapranno contribuire alla ricerca. Tornare a discuterne significa dare una prospettiva ai progressi di ogni settimana e chiedersi quale capacità complessiva stiano costruendo, un aggiornamento dopo l’altro.
Fonti e crediti delle immagini
- OpenAI, Charter. Definizione dell’AGI adottata dall’organizzazione.
- Meredith Ringel Morris e colleghi, Levels of AGI for Operationalizing Progress on the Path to AGI. Prima versione del 2023, revisione consultata del settembre 2025.
- Google DeepMind, Measuring progress toward AGI: A cognitive framework, 17 marzo 2026.
- OpenAI, GPT-6 Astra: A new generation of intelligence, settembre 2026.
- Anthropic, Claude Fable 5.2 and Mythos 5.2, 9 novembre 2026. Risultati e dimostrazioni dichiarati dal produttore.
- Google DeepMind, risultato di Gemini Deep Think alle Olimpiadi internazionali di matematica, 21 luglio 2025.
- Google DeepMind, Accelerating Mathematical and Scientific Discovery with Gemini Deep Think, 11 febbraio 2026.
- ARC Prize, OpenAI’s GPT-6 Astra on ARC-AGI-3, 3 settembre 2026.
- METR, Task-Completion Time Horizons of Frontier AI Models. Definizioni e limiti della misura; pagina aggiornata l’8 settembre 2026.
- METR, Time Horizon 1.1, 29 gennaio 2026.
- Blaise Agüera y Arcas e Peter Norvig, Artificial General Intelligence Is Already Here, Noema, 10 ottobre 2023.
- Lex Fridman Podcast, intervista a Jensen Huang, trascrizione ufficiale, marzo 2026.
- Ben Thompson, intervista a Greg Brockman su Astra, Stratechery, 4 settembre 2026.
- AGI Society, valutazione delle dichiarazioni di Jensen Huang e Greg Brockman sull’AGI, settembre 2026.
- Axios, intervista a Hassabis.
- Dwarkesh Patel, intervista a Dario Amodei, 13 febbraio 2026.
- AI Impacts, indagine sulle previsioni di 1.580 ricercatori. Dati raccolti nel dicembre 2024, rapporto pubblicato nel settembre 2026.
- Tim Genewein e colleghi, From AGI to ASI. Prima pubblicazione nel giugno 2026, versione aggiornata il 10 novembre 2026.
- OpenAI, Building standards for the next phase of AI, 21 settembre 2026.
- METR, Independent Assessment of AI R&D Acceleration at Anthropic in October 2026, 5 novembre 2026.
- AI Futures Project, aggiornamento delle previsioni sui tempi della ricerca AI sovrumana, 10 novembre 2026.
- Fotografia di Frontier, OLCF at ORNL, 2022, Wikimedia Commons. Licenza CC BY 2.0.
- Fotografia di Jensen Huang, Peter Dasilva, Commissione europea, 2024, Wikimedia Commons. Licenza CC BY 4.0; ritaglio preesistente.
- Fotografia di Demis Hassabis, Christopher Michel, 2025, Wikimedia Commons. Licenza CC BY-SA 4.0.